
现代应用交付的复杂程度已与十年前截然不同。过去,我们依赖静态负载均衡策略,在少量服务器之间调配可预测的流量。如今,我们面对的是动态多云环境、可随时启动或关闭的微服务,以及可能在一夜之间从1,000人激增至100万人的用户群。传统的规则驱动型负载均衡并非总能跟上这种变化。
这正是强化学习(RL)发挥作用之处。RL智能体通过持续观察环境并做出可最大限度提升整体性能的决策,有望比任何预编程脚本更好地适应实时变化。这就像严格照着食谱烹饪与凭直觉烹饪之间的区别:前者可针对已知条件进行扩展,后者则会随情况动态演变。
论点:随着应用基础设施日益复杂,我们必须从静态或基于启发式方法的负载均衡,转向由强化学习驱动的自适应系统,以保持韧性、优化性能,并使网络能够应对未来需求。
围绕AI的炒作并不少见,但强化学习(RL)是一个已开始在学术研究和实际试点中展现切实潜力的领域。这并非遥远未来的某种“可能性”;RL技术已在模拟环境和某些生产环境中取得积极成果。
强化学习入门:为何值得采用
在深入探讨之前,先用更简单的方式说明强化学习。可以将智能体想象成系统的“大脑”,负责收集数据、做出决策,并根据条件变化调整策略。智能体置于动态环境(例如多云系统)中,当取得成功结果(如降低延迟或提高吞吐量)时,就会获得“奖励”。随着时间推移,智能体会不断优化策略,从而更频繁地获得更高奖励。
- 自适应且持续学习:与受限于特定规则集的静态算法不同,RL会持续从新的流量模式中学习。
- 可扩展的逻辑:RL框架可以协调数千个变量,例如CPU使用率、内存消耗或节点可用性,并同时对这些变量进行优化。
- 抗冲击能力:面对突发变化(例如节日期间电商流量激增),系统可以自行调整,无需等待人工调整阈值。
争议:使用强化学习是否有些大材小用?
一些工程师认为RL属于过度设计。“没坏的东西为什么要修?”这是一个常见问题。但F5发现,在一些新的客户场景中,例如全球分布式微服务或多租户边缘部署,静态规则不仅并非理想选择,有时甚至会带来风险。上个季度还十分适用的策略,在新条件下可能会彻底失效。在这些场景中,RL能够在不确定性中灵活适应,可能发挥关键作用。
走进F5:一窥真实场景中的实验
在F5内部,我们开展了小规模强化学习实验,所用模拟环境以真实客户流量为模型。以下是其中一个示例:
- 实验设置:我们构建了一个合成的“购物狂欢”场景,模拟不同大洲的大型购物活动同时启动。流量以不可预测的方式激增,内存密集型查询也会在非常规时段骤增。
- RL智能体:RL智能体部署在容器化环境中,可根据使用模式调整要启动的微服务。它通过学习,将CPU密集型任务路由到配备专用硬件的节点,同时将资源需求较低的进程转移到成本更低的云实例。
- 结果:与采用一定自动扩缩容机制的传统轮询方法相比,RL驱动的方法将平均响应时间缩短了12%至15%。更重要的是,在流量激增至极端水平时,该方法还能使错误率保持得更加稳定。
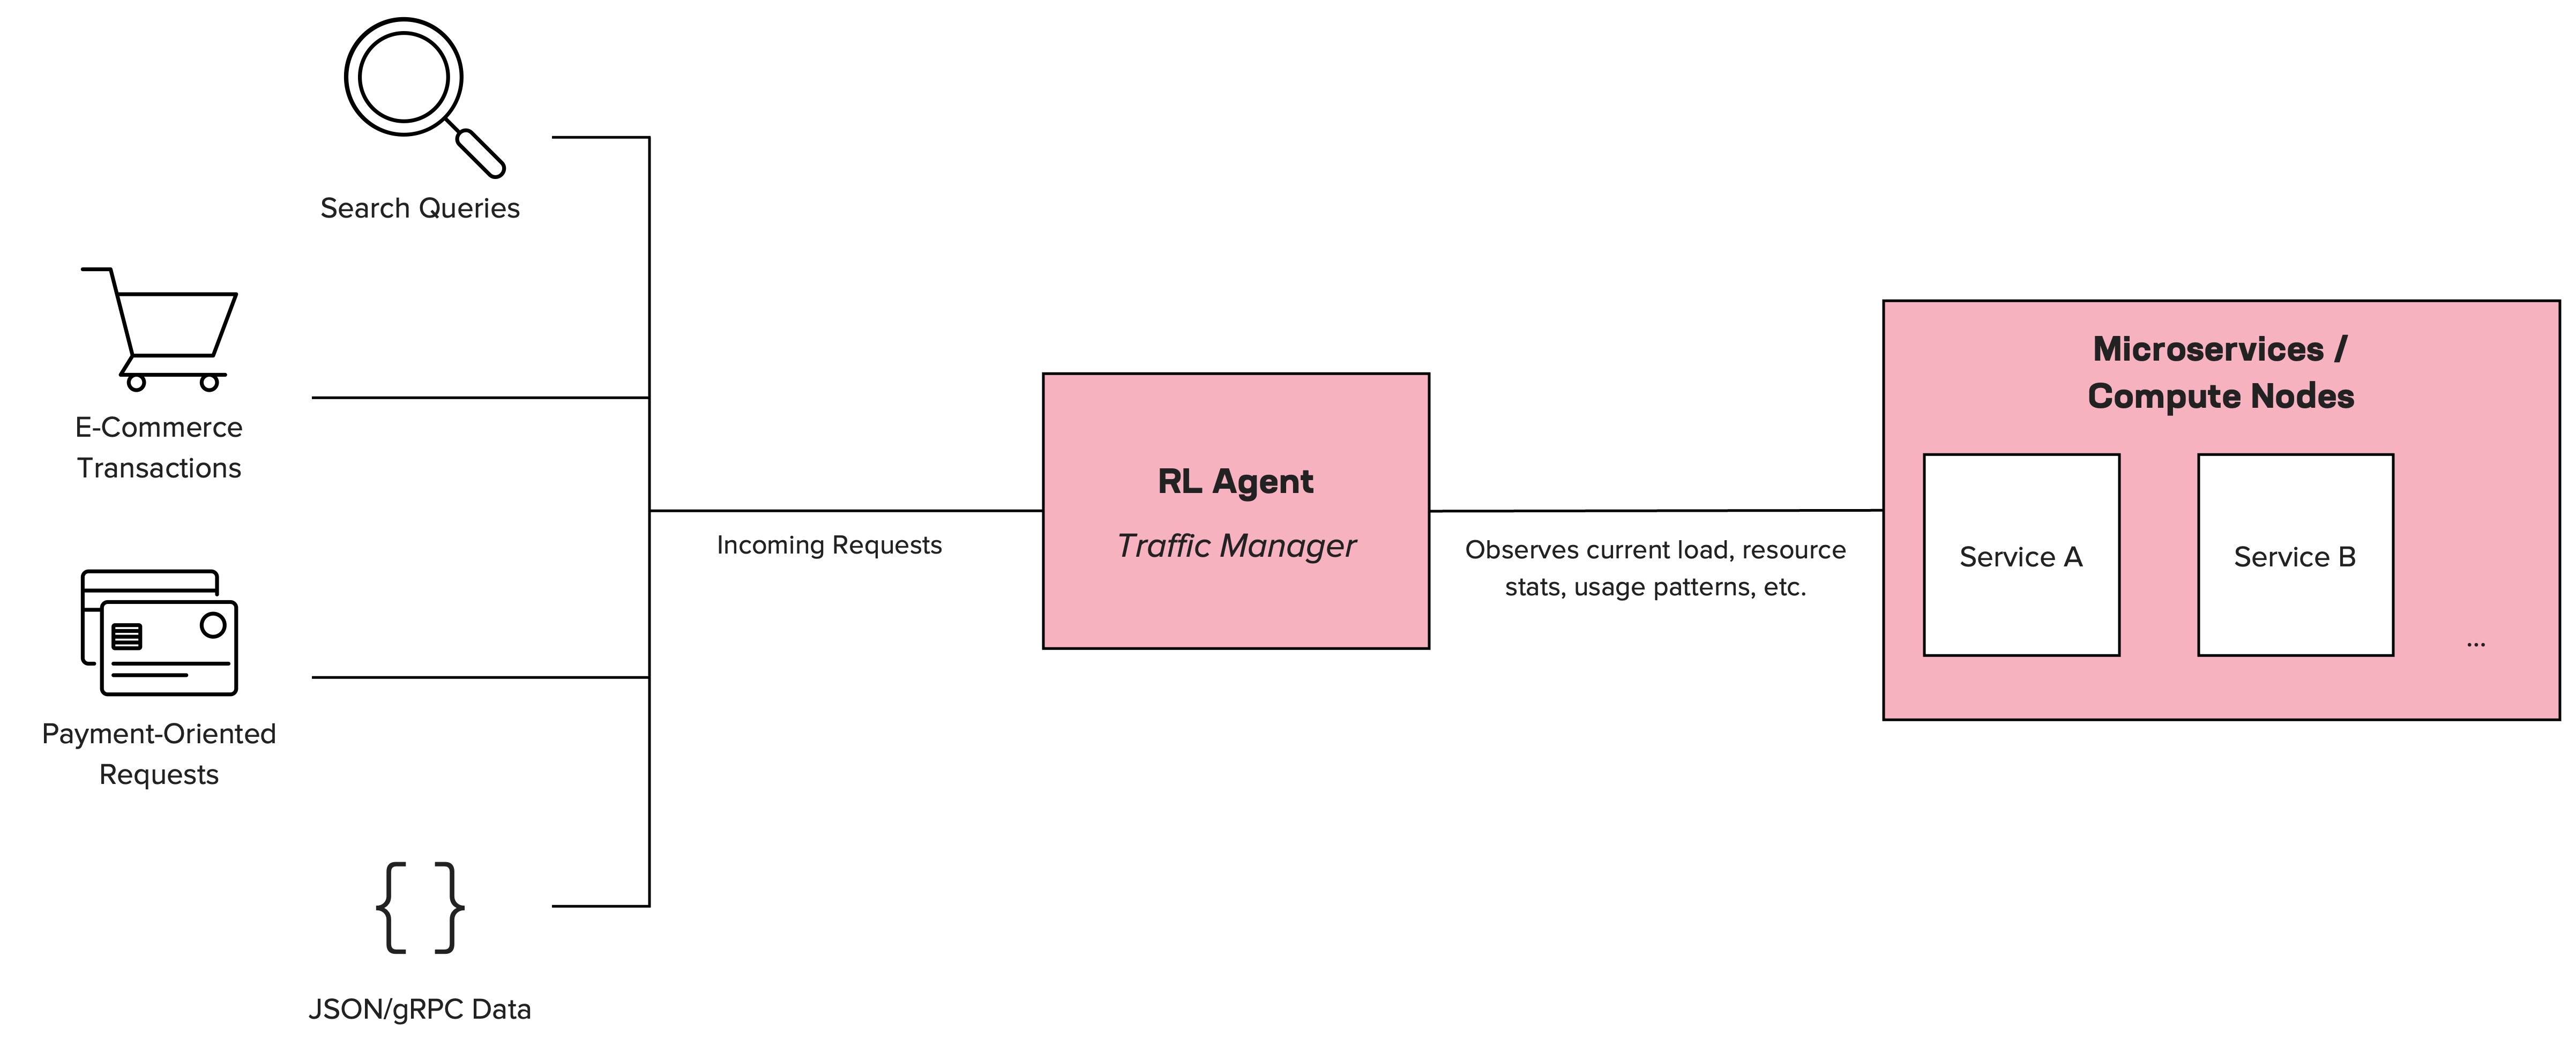
此概念图展示了RL智能体如何取代典型负载均衡器(或与其协同运行)。
- 传入请求:用户或客户端应用程序发送请求。
- RL智能体:充当流量管理的“大脑”。它会监控实时指标(CPU使用率、内存使用情况、错误率),并做出路由或扩缩容决策。
- 微服务或节点:RL智能体根据学习结果启动适当的微服务,或将流量路由到特定节点。
此示例表明,在许多场景中,强化学习(RL)的表现有望优于传统负载均衡。
潜在隐患:暂时不要盲目追捧
当然,RL并非万能之策。训练可能耗时较长,而且我们必须投入资源建立可靠的监控机制,确保RL智能体不会为了“钻奖励信号的空子”而做出损害整体效果的短期决策。尽管如此,在有效的情况下,RL的表现仍可明显优于传统启发式方法。此外,还需考虑以下几点:
1. 复杂性与可靠性
- 问题:RL会给本已复杂的系统增加一层新的复杂性。如果管理不当,智能体可能会陷入局部最优解,或在相互冲突的目标(吞吐量、成本和延迟)之间反复权衡。
- 缓解措施:采用混合方法,由RL处理高层决策,并由经过验证的启发式方法提供故障保护。
2. 数据质量与奖励设计
- 问题:强化学习依赖奖励信号。如果指标存在偏差,或激励了错误的行为,智能体可能会利用环境中的特殊机制,而这些机制无法转化为实际业务价值。
- 缓解措施:投入资源,建立可靠的监控机制,合理设计指标,并开展全面的离线测试。
3. 伦理与监管问题
- 问题:如果强化学习(RL)智能体为了提高成本效益,无意中对某些地区或使用模式采取差别对待,可能会触及道德或法律红线。
- 缓解措施:实施团队必须预先定义允许执行的操作,并定期审核由机器学习驱动的决策。
2025年更广泛的行业采用趋势
除了我们的内部实验,业界也在热议强化学习(RL)。以下是部分亮点:
- 会议论文:NeurIPS ‘24等知名AI会议NeurIPS ‘24设有专门议题,探讨用于网络优化的分布式强化学习。
- 云服务提供商:主要云服务提供商现已推出基于强化学习的自动扩缩容和流量路由专用工具包,弥合了学术研究与实用工具之间的差距。
- 边缘部署:随着5G和边缘网络不断发展,亟需对众多小型数据中心的资源进行编排。RL具备良好的适应性,适用于这类动态变化的地理分布式架构。
不过,企业采用RL进行流量管理仍处于早期阶段。许多企业担心其不可预测性,或难以向合规团队或监管机构解释RL的决策,因此仍持谨慎态度。这凸显了可解释人工智能(XAI)的重要性。这一活跃的研究领域旨在阐明ML模型如何做出决策。
2030年愿景
我认为,未来五年,基于强化学习(RL)的流量管理将从小范围试用逐步转向在具有前瞻性的企业中得到更广泛的采用。到2030年,我预测:
- 动态多云编排: RL将成为跨多个公有云和私有云编排工作负载的常规方式,在成本和性能优化方面远比目前的手动调优更高效。
- 与AI可观测性更紧密地集成:能够无缝记录、可视化和解读强化学习智能体决策的工具将有助于缓解合规方面的担忧,并简化调试。
- 协作式智能体:多个强化学习智能体将在同一环境中协同工作,各自承担专门任务,如同一个专家团队:有些负责资源分配,有些则专注于安全或服务质量约束。
尽管一些持怀疑态度的人质疑强化学习能否兑现这些承诺,但在我看来,强化学习是应对复杂性增加所带来的必然挑战的一条有力路径。根据我的经验,这一趋势已初具势头。随着企业寻求适应性更强、更智能的解决方案,我相信强化学习将继续塑造流量管理的未来。
后续步骤
那么,现在是否该淘汰久经考验的负载均衡器了?还不是时候。不过,如果尚未尝试基于RL的方法,现在确实应该开始探索。可先在风险较低的环境中进行测试,衡量性能提升,并与跨职能团队协作。这将有助于制定切实可行的路线图,在发挥RL潜力的同时兼顾现实限制。
相关博客文章


2023年应用策略现状:成本与复杂性是推动多云网络发展的首要因素
多云网络解决方案可在核心、云和边缘环境之间实现无缝、安全的互联,为解决当今混合IT面临的挑战提供支持,因而备受业界关注。