本篇博客介绍Volterra如何帮助用户以集群化方式运营应用和基础设施。我们将说明基于控制平面的方法如何简化大规模应用集群群组的运维,并将其与Google Anthos、Azure Arc、Rancher等多集群管理平面方法进行比较。
看到这里,您可能会想:我们是不是只是在玩营销话术,把多集群管理称为集群群组运维?其实,多集群管理与集群群组运维面向不同的使用场景,二者的架构也存在根本差异。多集群方法适用于集群数量相对较少,并且需要采用一致的运维模式来管理这些基础设施集群的场景。相比之下,集群群组方法适用于大规模集群场景(例如机器人、汽车和工业网关中的K8s集群,以及数十个公有云区域等),需要在这些大规模集群中部署相同的应用以及网络和安全配置。接下来的两节将更详细地介绍并比较多集群运维与集群群组运维方法。
多集群方法
多集群管理方法适用于由单个团队运维数量相对较少的集群的用例。例如,可在少数几个可用区中部署数十个集群,以缩小故障影响范围。同样,用户也可以选择在少数几个区域中部署多个集群,以满足监管要求。
以下两个示例概述了多集群解决方案的工作原理:
配置
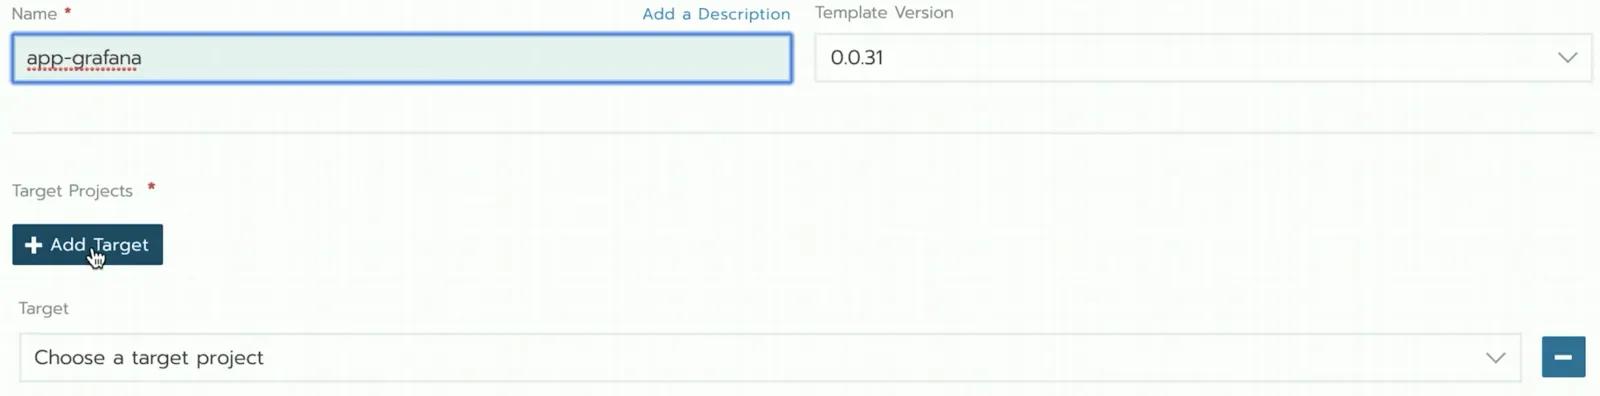
以图1所示使用Rancher多集群方法部署应用为例。在多集群方法中,客户需要逐一选择应用部署的目标站点。集群数量较少时,这种逐一选择目标站点的方法可以满足需求。但这种方法并非为上千个集群这样的规模而设计。
可观测性
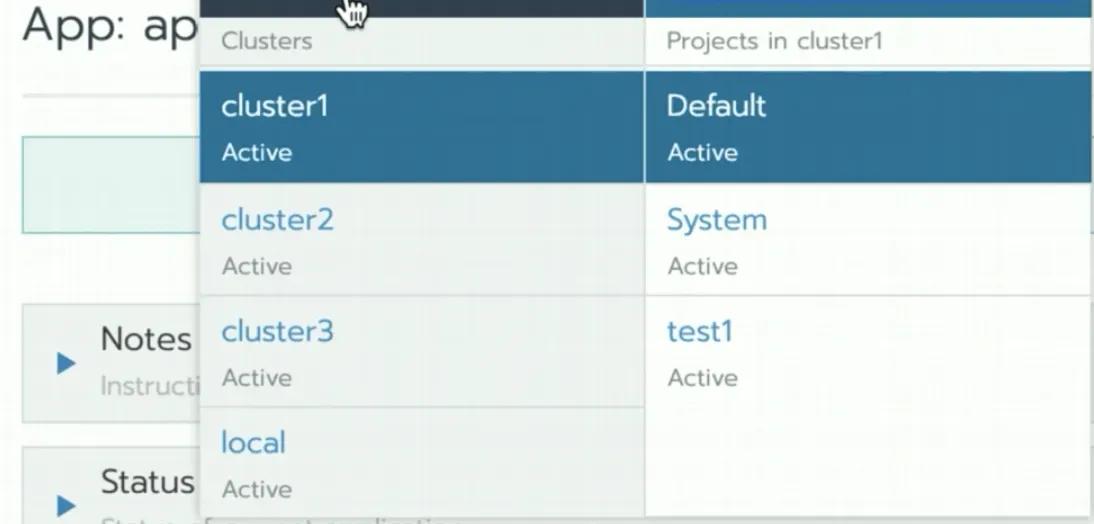
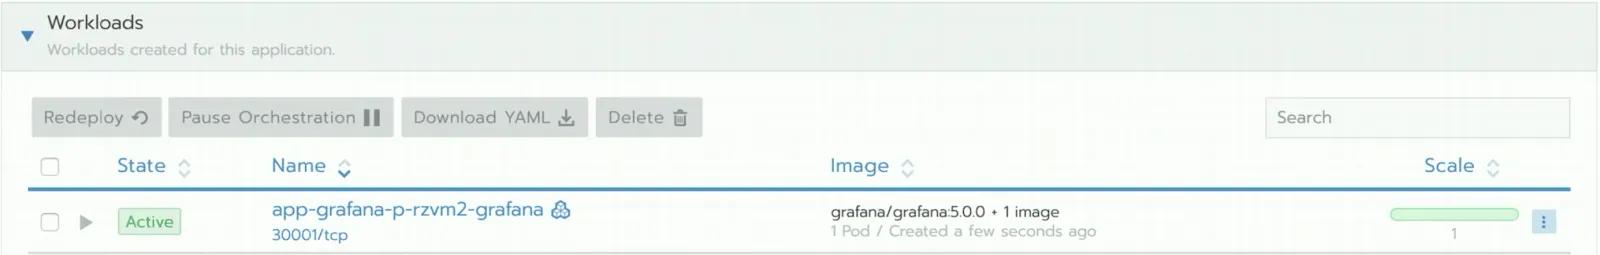
图2以Rancher为例,展示了多集群方法中的可观测性工作原理。采用多集群方法时,客户必须逐一双击每个集群,才能查看已部署Pod的状态以及CPU和内存资源利用率。这种逐一观察目标站点的方法适用于集群数量较少的情况,但不适合管理大量集群。
集群1:
集群 2:

解决第一个示例中所述问题的一种直接方法是编写某种自动化脚本,对每个集群重复执行任务。例如,每当添加新集群时,该脚本可以执行以下操作来部署新应用(如checkoutservice)
export KUBECONFIG=~/Documents/kubeconfig/ce01-ashburn-aws-staging
kubectl apply -f checkoutservice.yaml
但是,部署、升级、策略、资源预留等每项操作都需要构建相应的自动化机制。这些自动化机制不仅要跨多个集群执行各项操作,还需要处理故障情况。此外,在更复杂的场景中,例如对部分集群进行Beta测试,或对所有集群执行滚动升级,自动化机制会变得越来越复杂。我们在流程早期就意识到了这一点,因此构建了一个分布式控制平面,通过下文所述的集群组运维方法提供所有这些功能。
Volterra的集群组运维方法
机群运维是指客户以声明方式一次性定义整个机群的预期状态,随后由系统负责确保受影响的站点与该预期状态保持一致。预期状态包括应用软件版本、基础设施软件版本(例如操作系统版本)、网络策略、安全策略和资源预留等。
意图生效后,用户可通过系统查看站点群的状态和运行状况。也就是说,用户可以在一个统一界面中汇总查看站点群内所有站点的基础设施和应用运行状况,从而降低客户运维团队的操作复杂性。用户无需逐一进入每个站点或集群来确定其运行状况,也无需编写自动化工具来汇总信息。
Volterra的集群运营方法包含三个主要组成部分:分段、配置和可观测性。以下各节将分别介绍这些组成部分。
设备群分段
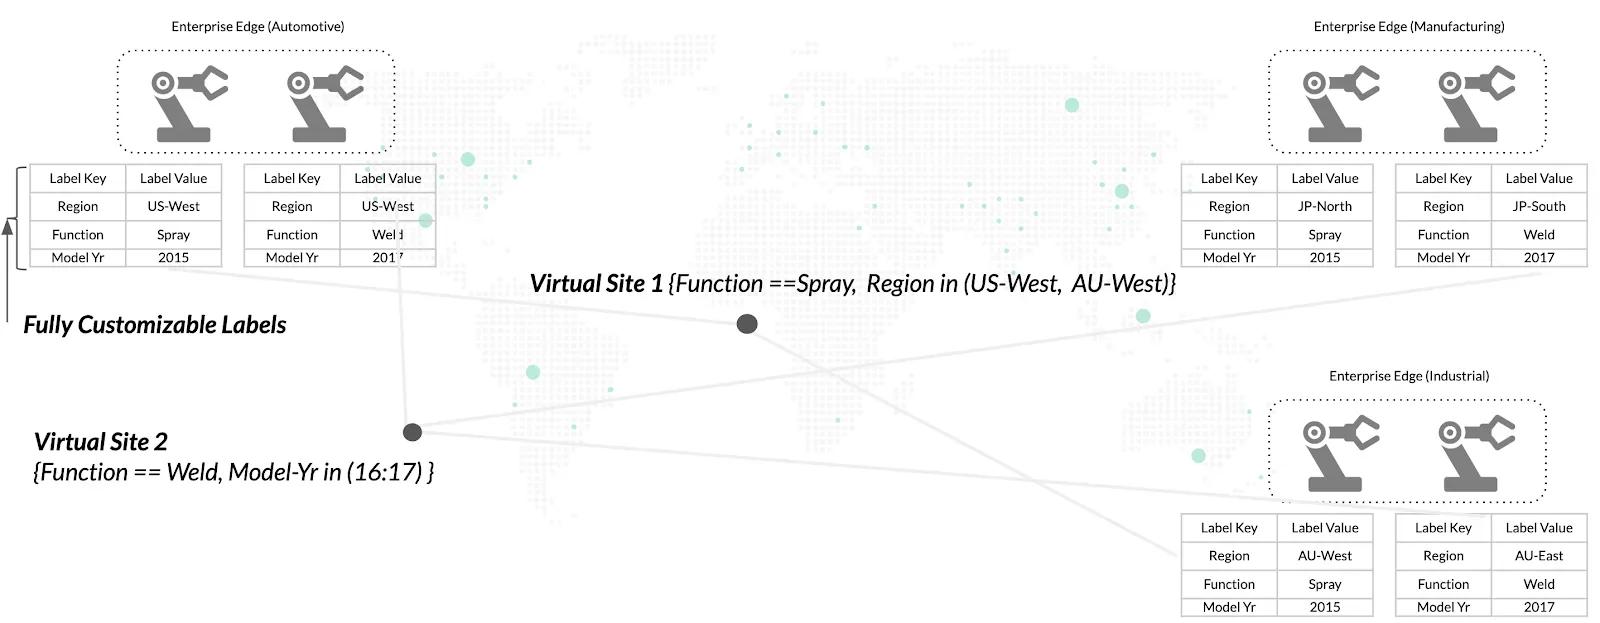
用户的站点群中通常包含开发、测试和生产计算站点等多种站点。根据组织策略,不同工作负载需要部署到特定的站点分段,例如,开发工作负载只能部署到开发站点。用户可以灵活地使用由键和值两部分组成的标签来标记站点。例如:
- 标签键=region。标签值=US-West、JP-North、JP-south
- model-year=(2015, 2016, 2017, 2018)
- function=(喷涂, 焊接)
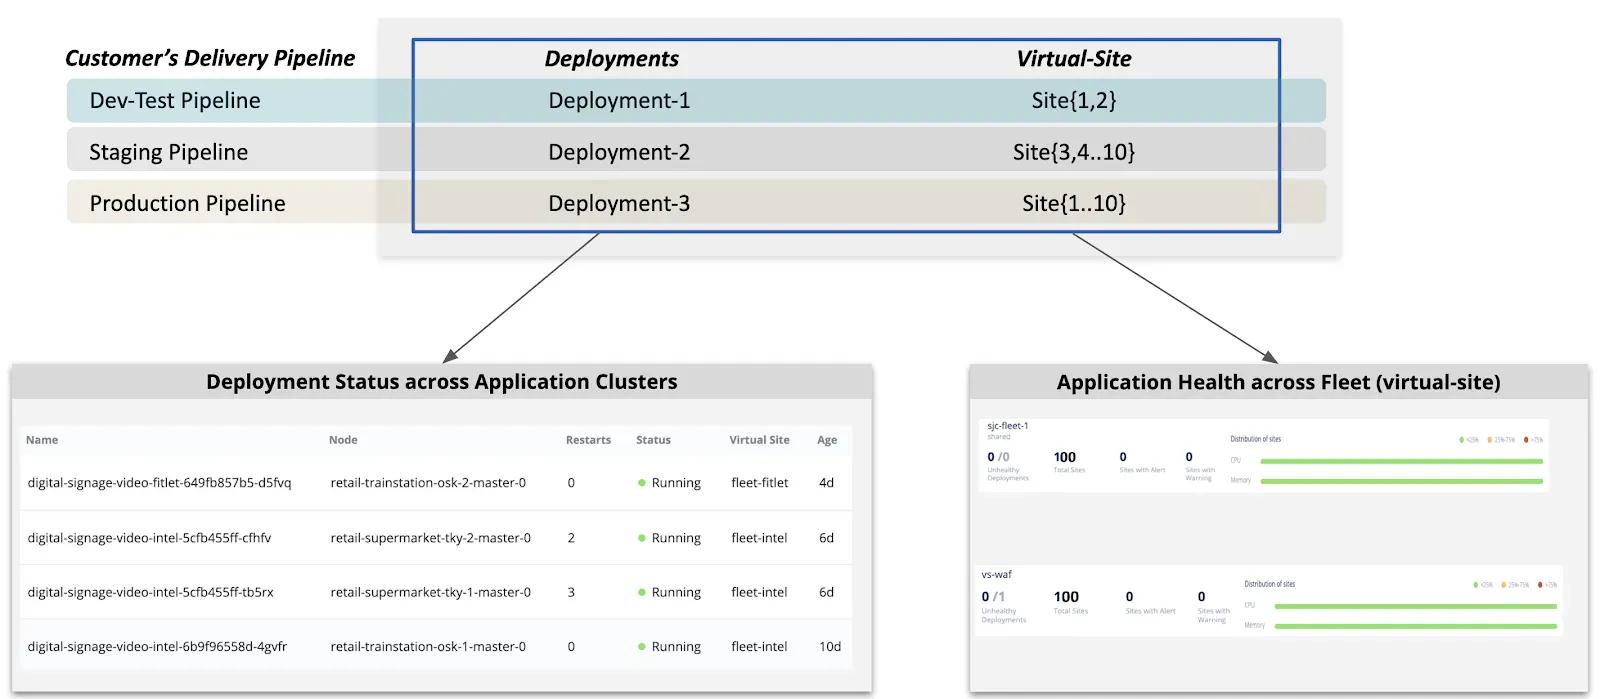
为站点添加标签后,用户可以使用标签键值条件定义“虚拟站点”。例如,在多云场景中,用户可以将站点标记为dev、pre-prod和prod。下图3展示了一个使用上述标签键值的机器人用例示例。
以下是Volterra上的一个配置片段,用户可使用blend/go-sdk语法创建虚拟站点。在此示例中,各个站点均使用标签键key=ves.io/country和标签值ves-io-jpn进行标记。
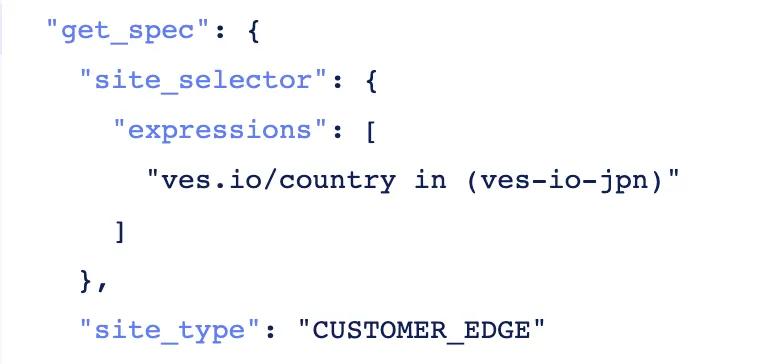
用户通常采用这样的运维模式:预先划分设备群组,并在站点配置时为其添加标签,以将其纳入相应群组。虚拟站点与用户现有的运维模式高度契合。为新站点配置适当的标签后,该站点会自动加入之前定义的虚拟站点,无需额外的手动操作。此外,Volterra会发现硬件制造商或公有云类型等预配置的信息,并据此预填充系统标签。用户也可以选择使用这些自动发现的标签来定义虚拟站点。
站点群配置
以下三个示例最能说明设备群配置功能:
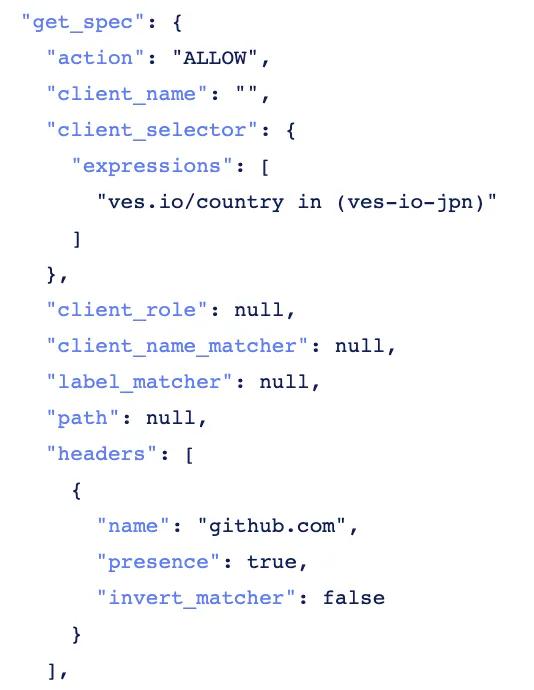
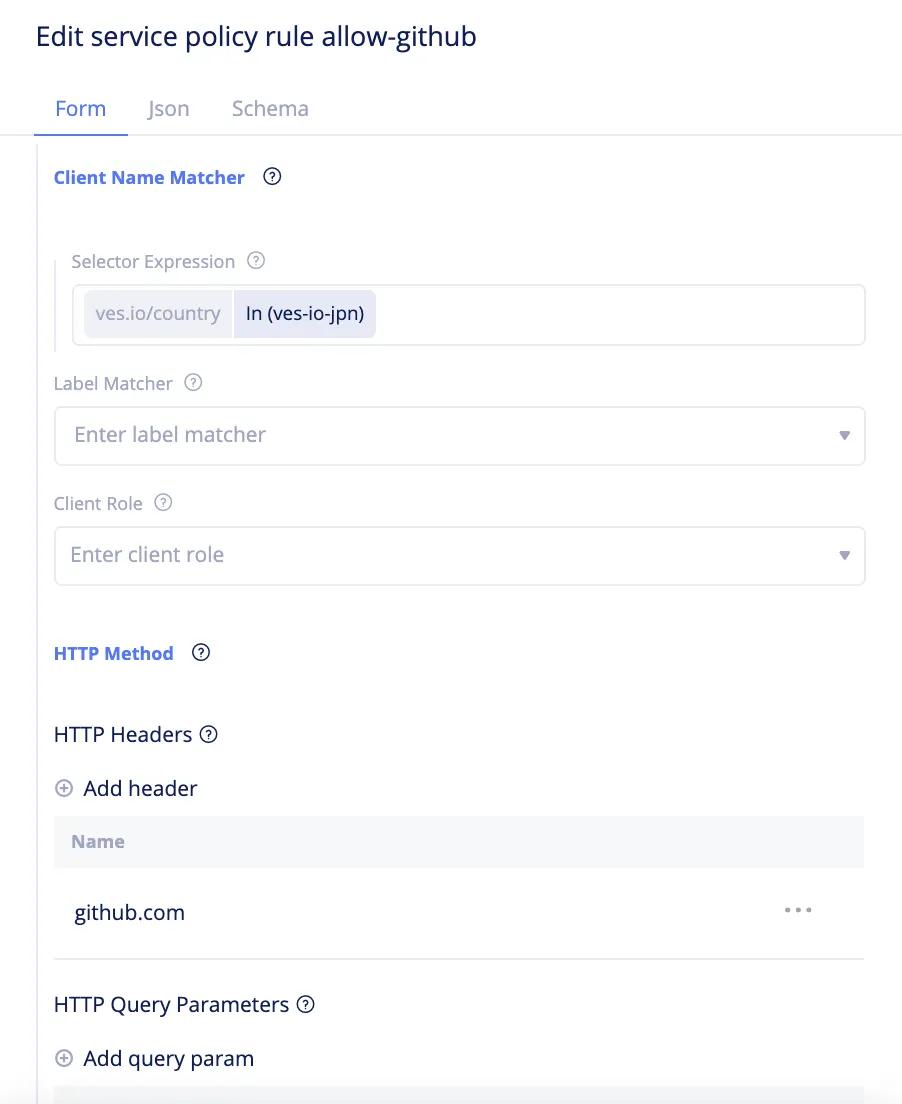
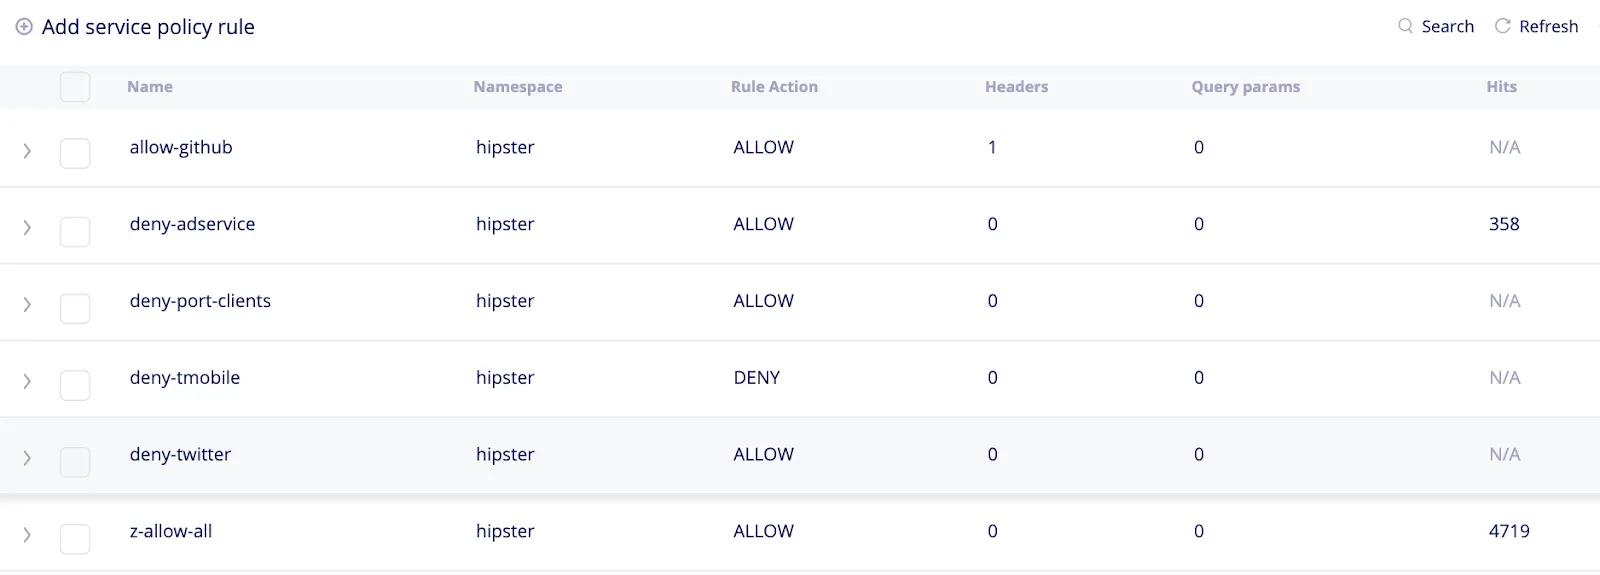
- 网络/安全策略配置 ——以客户推出一项新服务为例,该服务要求每个集群都能与特定URL通信,例如 github.com。用户通常采用白名单机制,即仅允许集群访问特定目标。因此,要推出这项新服务,用户需要逐一访问每个集群并修改网络策略,将 github.com 添加到白名单。此外,客户希望先在少数测试站点进行测试,再推广到所有站点。要在Volterra上实现这一目标,客户首先在Volterra SaaS控制台中定义一个“test”虚拟站点,用于选择机群中的一部分。然后,用户定义网络策略,例如URL白名单(本例中为 github.com),并将其应用于“test”虚拟站点。Volterra的分布式控制平面会将网络策略发送到该虚拟站点所选各站点的本地控制平面(如上所述)。每个站点的本地控制平面会应用网络策略,并收集各站点的规则命中统计信息。客户确认服务按预期运行后,即可将该网络策略应用于“prod”虚拟站点,由该虚拟站点选择机群中的其余站点。以下是使用JSON编写的配置片段,以及在Volterra系统UI中的配置示例。
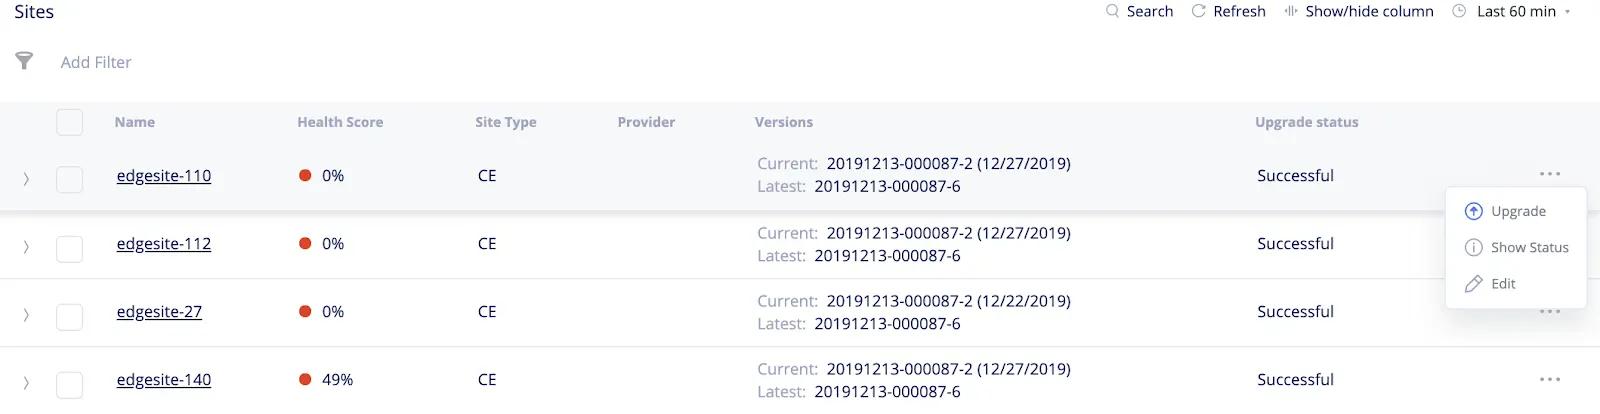
- 基础设施软件升级:机群配置功能支持用户升级整个机群(或部分机群)的基础设施软件,例如操作系统版本。首先,用户定义将操作系统从版本1升级到版本2的意图。然后,用户定义整个机群的部署策略,例如滚动更新、蓝绿部署等。滚动更新是指依次升级机群(或部分机群)中每个站点的操作系统。蓝绿部署策略是指用户希望在一组“蓝色”站点(例如开发站点)上测试升级,并与尚未升级的“绿色”站点(例如生产站点)进行运行状况比较。无论采用哪种策略,Volterra的分布式控制平面都会按照部署策略,将版本2软件发送到虚拟站点所选各站点的本地控制平面。每个站点的本地控制平面采用A/B方式升级操作系统,即创建新分区,在其中部署版本2,并支持客户评估运行状况。如果版本2安装失败,系统会自动回滚到原分区中的版本1。以下截图展示了如何使用Volterra SaaS门户升级基础设施软件。如下一幅图所示,用户可以查看所有站点当前的基础设施软件版本以及可用的最新软件版本。用户可以根据运维模式轻松升级特定站点或所有站点。
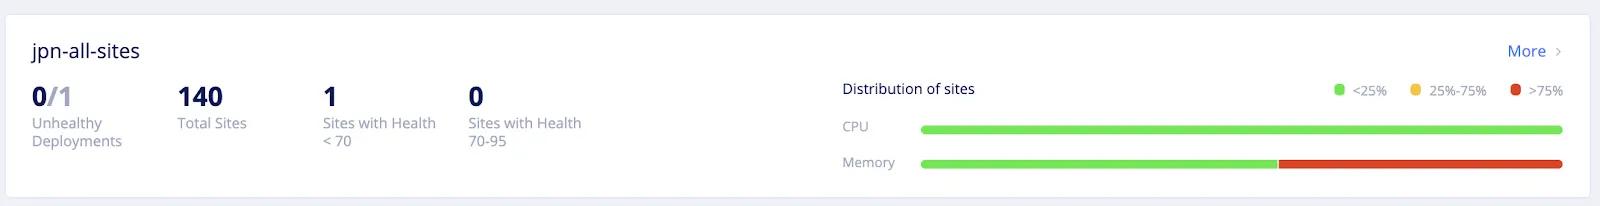
- 在整个站点群中部署应用:Volterra提供名为Virtual Kubernetes(vK8s)的对象,支持用户通过Kubernetes API管理整个站点群中的应用。用户使用标准Kubernetes方法(即Kubeconfig文件和Kubernetes API)及部署清单文件来部署应用,并指定需要部署应用的站点范围(或整个站点群)。随后,Volterra的Virtual Kubernetes(vK8s)负责将应用部署到站点群中的每个站点(或指定范围内的站点)。如果应用部署期间发生连接或基础设施故障等问题,Volterra Virtual Kubernetes会遵循Kubernetes的最终一致性模型范式,持续重试部署。以下屏幕截图展示了一个示例:用户在名为“jpn-all-sites”的虚拟站点上部署名为“kuard”的应用(请参阅Kubernetes-up-and-running-demo-app)。该虚拟站点选中了站点群中的140个站点。要添加新部署,只需单击“添加部署”,然后通过虚拟站点指定部署位置。
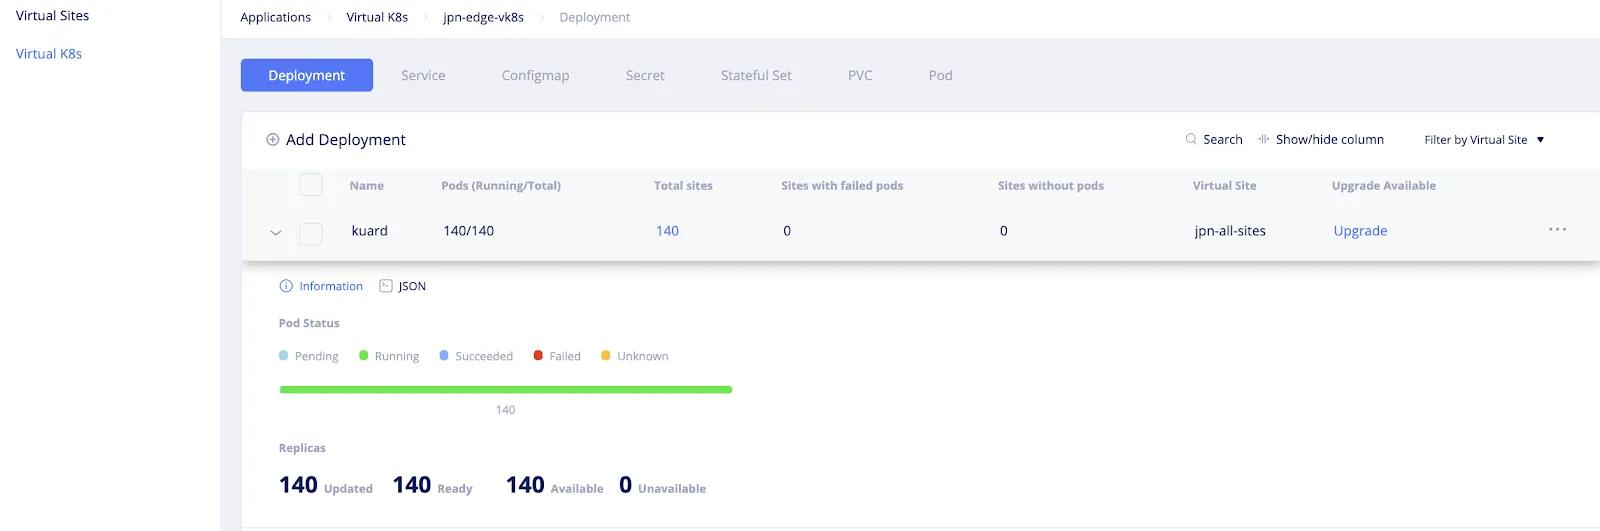
如果将带有适当标签的新站点添加到站点群,该站点会自动添加到虚拟站点(本例中为jpn-all-sites),并自动应用站点群配置(本例中为Kuard部署),从而减轻运维团队的负担并避免人为错误。
集群可观测性
虚拟站点和Virtual Kubernetes(vK8s)不仅用于配置,还可汇总整个站点群中各分布式站点的运行状况。相比其他需要用户自行编写工具、逐一获取各站点状态并汇总信息的解决方案,这项功能非常实用。系统会自动汇总所有站点的运行状况,并通过统一视图集中呈现,从而降低客户运维团队的运维复杂性。收集的运行状况涵盖多个方面,例如应用部署状态、站点运行状况和应用运行状况等。
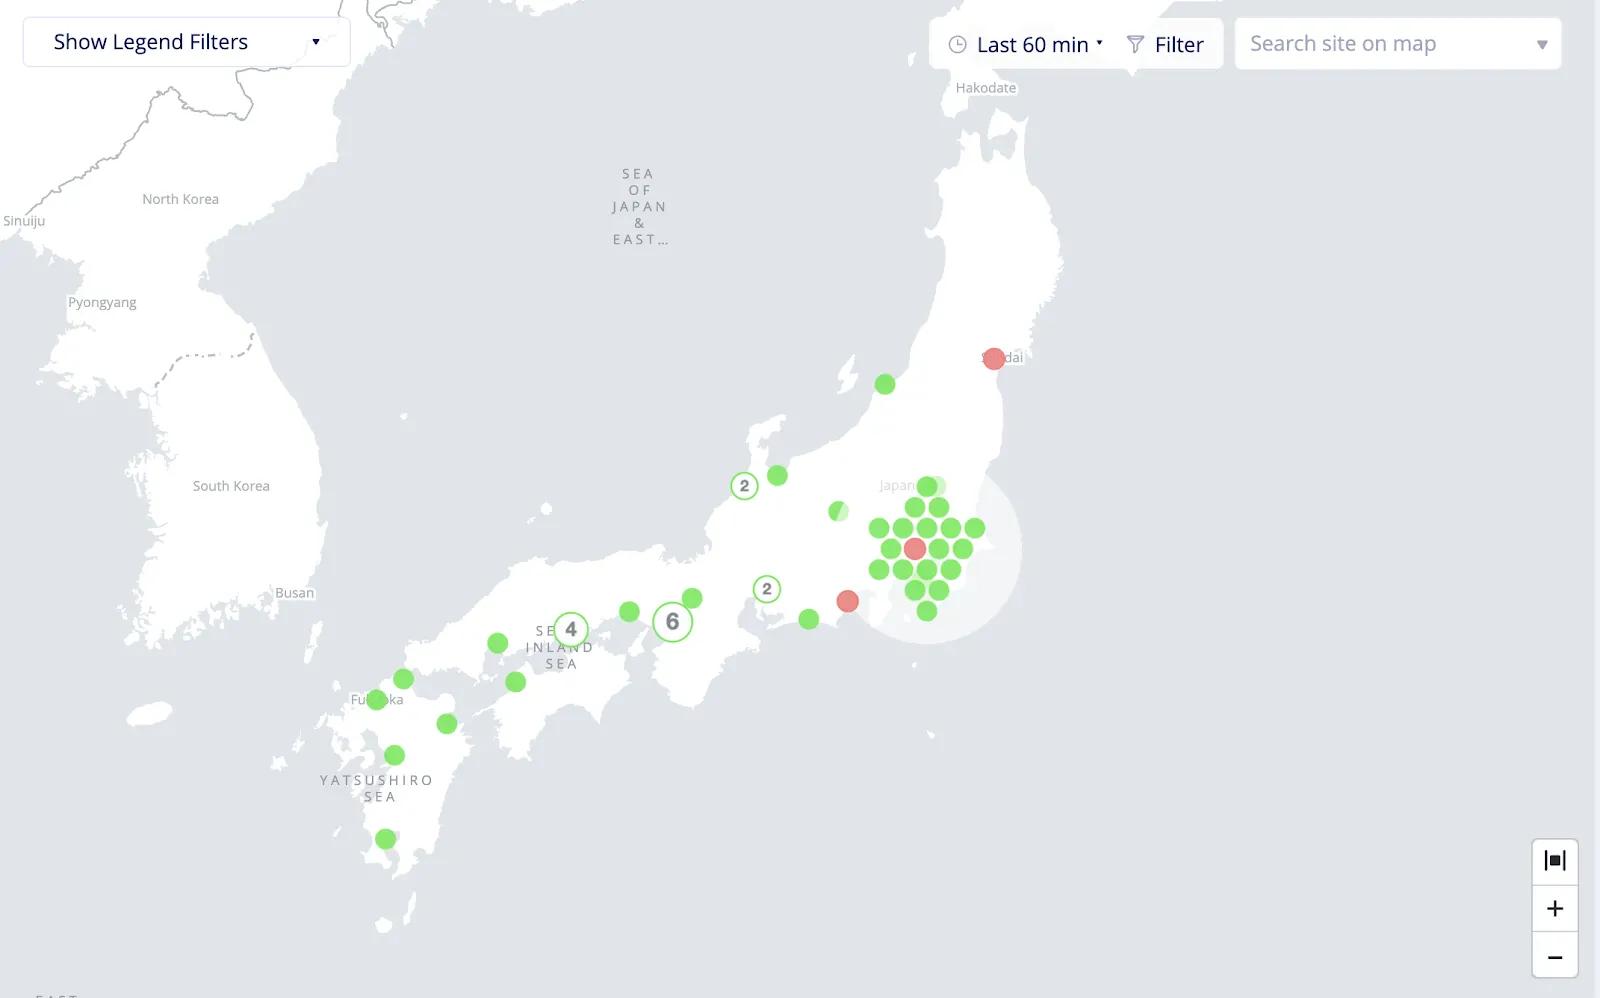
用户可以在地图上快速查看所有站点的运行状况概览,如下方截图所示。颜色表示健康评分:高于75为绿色,40至75为橙色,低于40为红色。健康评分是由连接性、可靠性、安全性和性能(即资源消耗)汇总得出的综合评分。
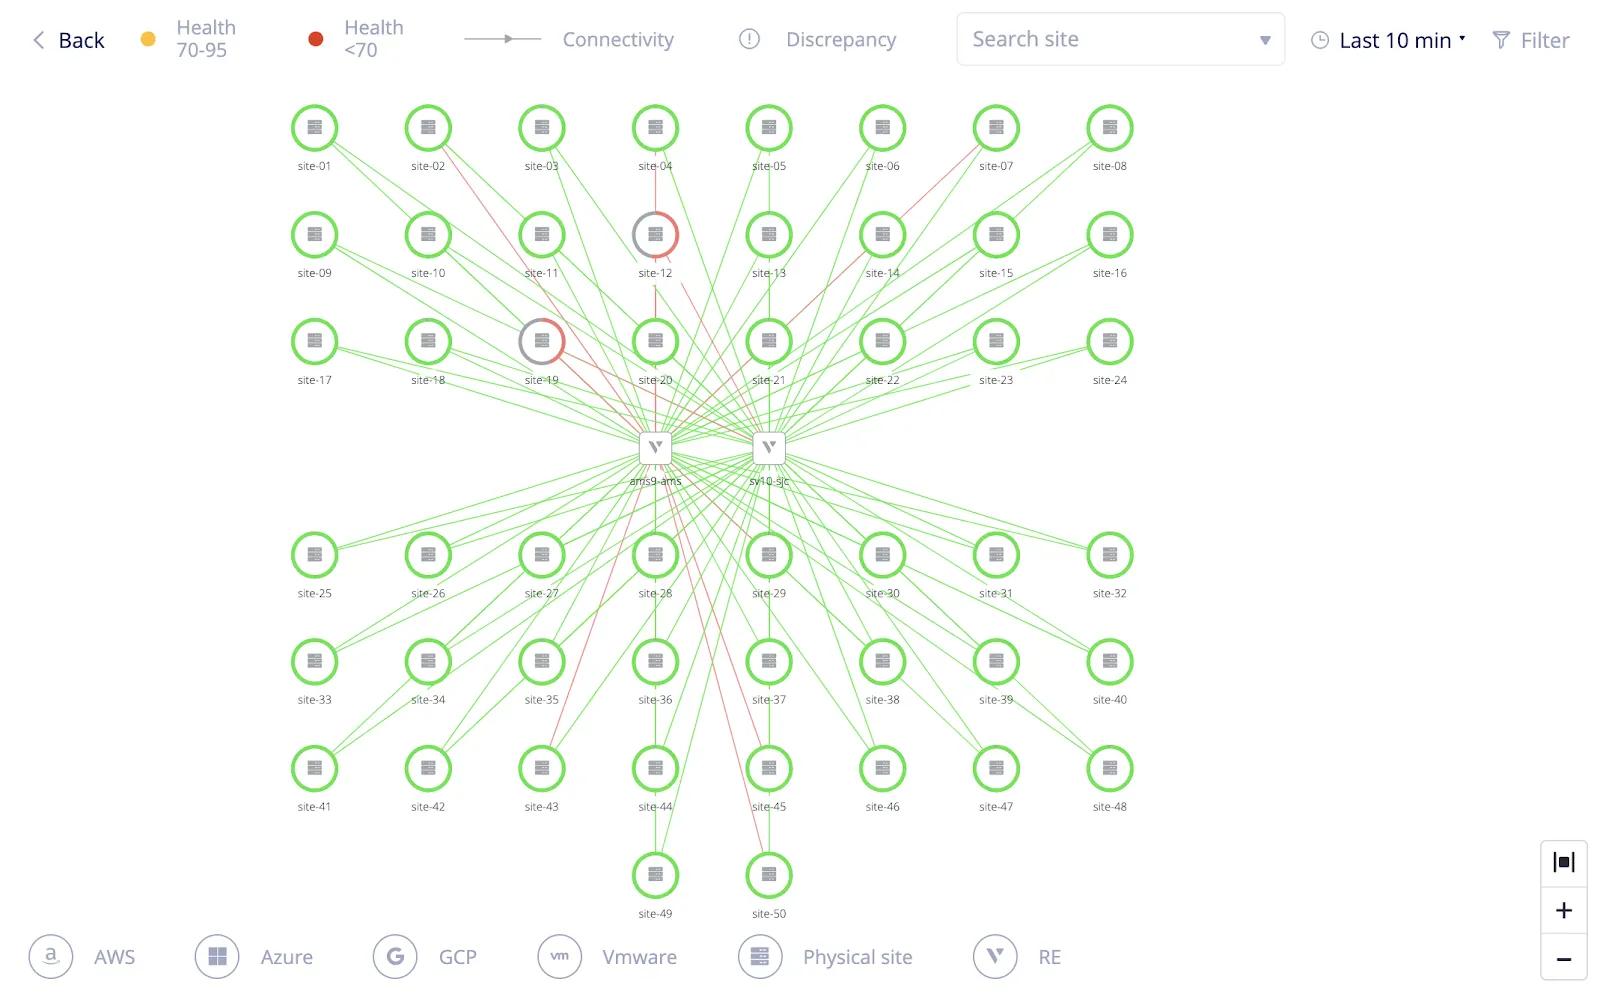
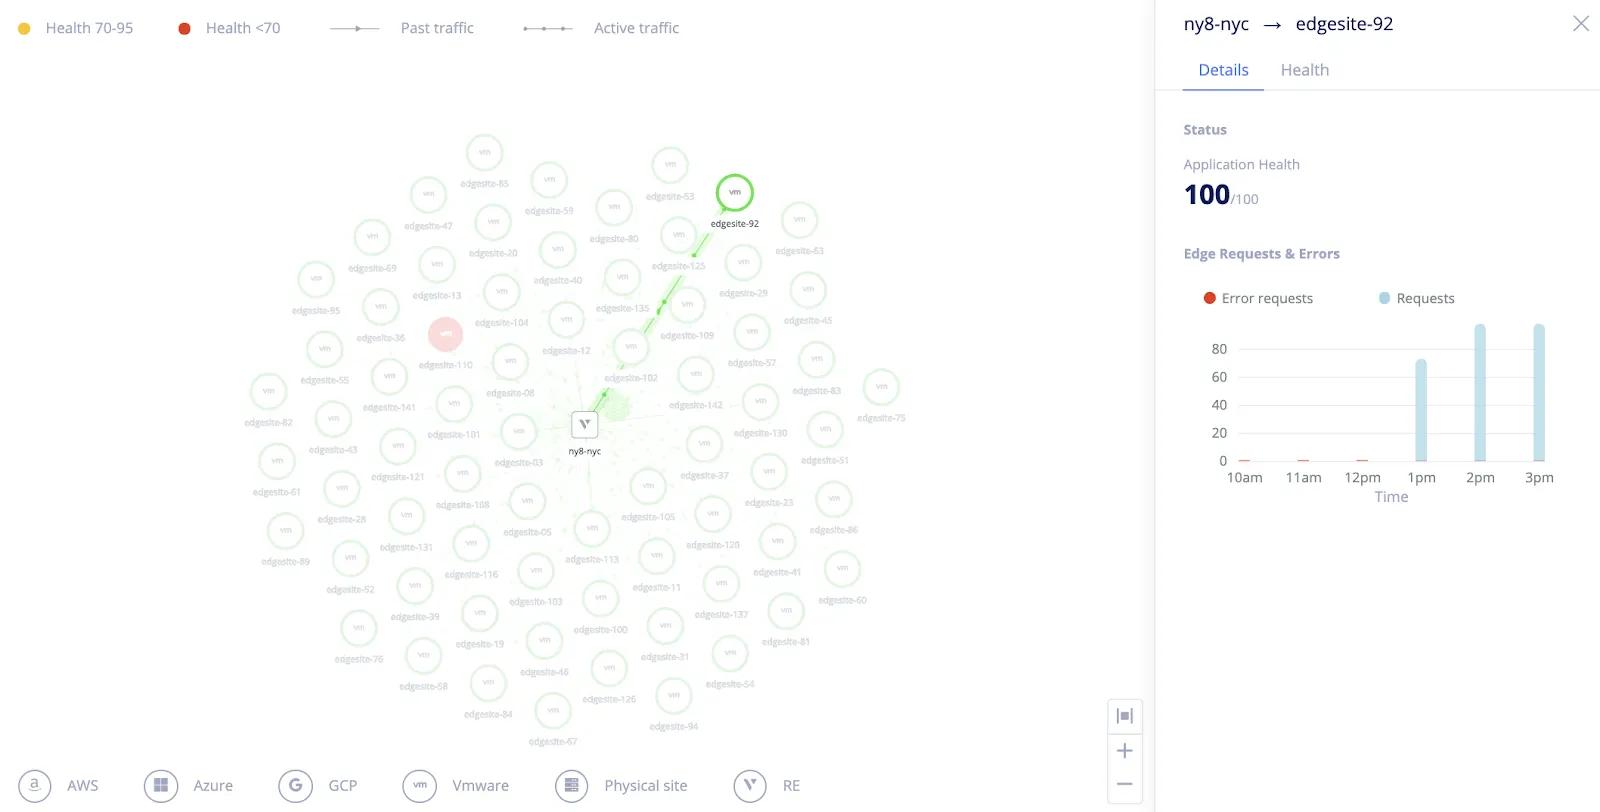
用户还可以查看所有站点的整体连接情况及站点运行状况。如图10所示,界面还会直观显示各站点与Volterra骨干网之间每条链路的连接运行状况。用户可以根据运行状况点击性能不佳的链路,查看请求和错误的详细统计信息,并排查连接问题,如图11所示。
接下来,用户可以通过各站点的CPU和内存负载分布,查看所有站点的汇总信息。这些信息有助于IT管理员或站点管理员识别哪些站点的资源利用率较高,可能面临资源耗尽的风险。站点管理员可以设置警报,以便在资源消耗超过阈值时收到通知。在此屏幕截图中,用户可以看到一半的站点已使用超过75%的可用内存。无需逐个点击站点,也无需编写其他工具,即可获取这些信息。
fleet对象的持续验证功能可显示POD部署状态,包括已部署、正在部署或部署失败的POD数量。部署完成后,还可查看Pod的运行状况,例如正在运行、正在等待镜像或内存不足等。
此外,用户还可以查看安全策略有效性的汇总视图,并了解其所有站点的命中情况,如下方截图所示。
总结
要进一步了解如何使用Volterra的集群群组运维方法管理由3,000个集群组成的集群群组,请观看Volterra的演讲。该演讲在Kubernetes大会上发表,另请阅读Jakub Pavlik撰写的博客
在下一篇题为“生效时间”的博客中,我将介绍Volterra的分布式控制平面和骨干网络如何帮助配置在极短时间内传播至全球分布的站点,并确保配置的一致性。敬请关注!
关于作者
相关博客文章

Thingbot正转变为攻击平台
Lori MacVittie重点介绍了F5 Labs对2018年1月至6月全球物联网设备攻击的研究,并指出了其中令人警醒的影响。物联网设备不仅持续遭到利用,还被转变为攻击平台,这意味着攻击者可以更充分地利用这个必然增长的市场。
借助F5全新Quick Start,在AWS上快速开展业务
在AWS re:Invent开幕前,我们很高兴与大家分享F5与AWS之间全新的Quick Start集成。F5的Tom Atkins将介绍该服务如何启动、配置和运行在AWS上部署工作负载所需的计算、网络、存储及其他AWS服务。