AI智能体已经到来,它们不只是调用API或推送内容。它们会思考、决策、规划和委派任务,并在您的基础设施、服务和流量管理技术栈中执行这些操作。
问题在于,大多数系统根本不知道这些AI智能体在做什么。
传统可观测性旨在跟踪服务,也就是请求、响应、延迟、路径这些实际发生的事情。它并非用于理解请求为何发生,只能知道请求已经发生。但现在,流量可能源自智能体内部的递归推理循环,而日志中只能看到一条向/search发送的POST请求,其中包含有效负载并返回200状态码。
这不是可观测性,而是不透明性。
要安全地将AI智能体投入实际运行,尤其是在生产环境中,流量管理系统将成为整体策略中不可或缺的一环。
但首先,可观测性能力必须跟上,而这要从弥补三个关键缺口开始。
1. 不仅记录请求,还要记录决策
智能体不只是响应,还会做出决策和评估,选择延后处理、重新路由、升级处理或调用工具。如果只记录HTTP层,就会遗漏真正重要的部分,也就是事情发生的原因。
需要使用结构化日志,记录智能体的意图、所选操作、评估过的替代方案以及结果。需要记录决策路径,而不只是状态码。
应采取的措施:
- 扩展日志格式,以纳入以下语义字段:
intent、action taken、confidence score以及policy constraint。 - 按发起决策的智能体为决策添加标记,并跨工具调用进行端到端追踪。
2. 不仅跟踪路径,还要跟踪语义
当两个POST请求来自AI智能体时,即使发送到同一端点,其含义也可能截然不同。一个可能是事实核查请求,另一个则可能触发内容生成。虽然路径相同,但目的、上下文和风险却不同。
这意味着,语义标记必须成为路由和可观测性中的核心要素。
应采取的措施:
- 使用内联检查(有效负载或标头)提取意图标签,例如
summarize、verify_identity 或 generate。 - 将这些标签用于路由、速率限制和身份验证决策。不要对所有POST请求一概而论。
3. 持续监控行为
智能体的行为不同于无状态客户端。它们会不断演变、重试、停滞和适应。因此,可观测性系统需要突破单请求追踪的局限,开始构建行为画像。
您应该了解智能体的“正常”行为:会重试多少次、使用哪些工具,以及完成任务需要多长时间。当这些行为发生变化时,也应该及时掌握。
应采取的措施:
- 跟踪每个智能体身份的滚动指标:重试次数、任务深度和工具使用情况。
- 针对异常情况发出警报:循环、延迟漂移、工具频繁切换。
这对流量管理意味着什么
这一切都会切实影响我们赖以管理流量、保护应用安全并实现应用扩展的系统:
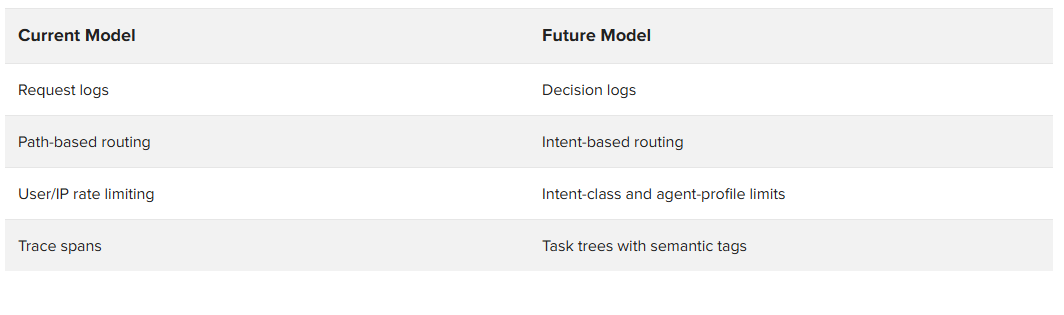
AI智能体不是用户,也不是客户端,甚至不是传统意义上的服务。它们是自主工作流。只有将其视为自主工作流,并从可观测性入手,我们才能避免继续在缺乏洞察的情况下盲目前行。
所以,流量已不再只是流量,基础设施也不应再按普通流量来处理。
开始以AI智能体正在监视的标准记录日志,因为它很可能确实在监视。
关于作者

Lori MacVittie是F5首席技术官办公室的杰出工程师兼首席技术布道师,在应用交付、自动化战略和基础设施领域拥有深厚的专业知识。无论是为AI智能体定义防护机制、剖析脆弱的多云架构,还是探索可扩展系统的极限,她都善于化繁为简。她在应用开发、IT架构以及网络和系统运维领域拥有30多年的行业经验。加入F5之前,她曾担任技术编辑,并因出色表现获得奖项。 MacVittie拥有计算机科学硕士学位,著述颇丰,出版作品涵盖安全、云和企业架构领域。她还热衷于桌面游戏和电子游戏,并且对奶酪有着毫不掩饰的鲜明见解。
Lori Mac Vittie 的更多博客文章相关博客文章


2023年应用策略现状:成本与复杂性是推动多云网络发展的首要因素
多云网络解决方案可在核心、云和边缘环境之间实现无缝、安全的互联,为解决当今混合IT面临的挑战提供支持,因而备受业界关注。