承诺,又是承诺。生成式AI应用有望提高人类生产力,进而提升企业利润。对于许多用例而言,从实验走向生产的过程依然紧张而危险,就像Konami于1981年推出的电子游戏Frogger。青蛙必须先穿过车流繁忙的街道,再渡过湍急的河流,才能回到家。它不能停在原地,但由于处处潜藏危险,也不能总是向前跳。
企业就像游戏中的青蛙。街道和河流则如同令人目不暇接的AI技术洪流。安全区域(街道上的空当和漂浮的原木)代表企业自研项目和供应商提供的产品与服务。汽车、卡车、乌龟和没有落脚点的水域,则代表生成式AI在伦理、法律、隐私和准确性方面的风险。终点就在对岸,生成式AI应用投入生产后,企业收益将大幅增长。
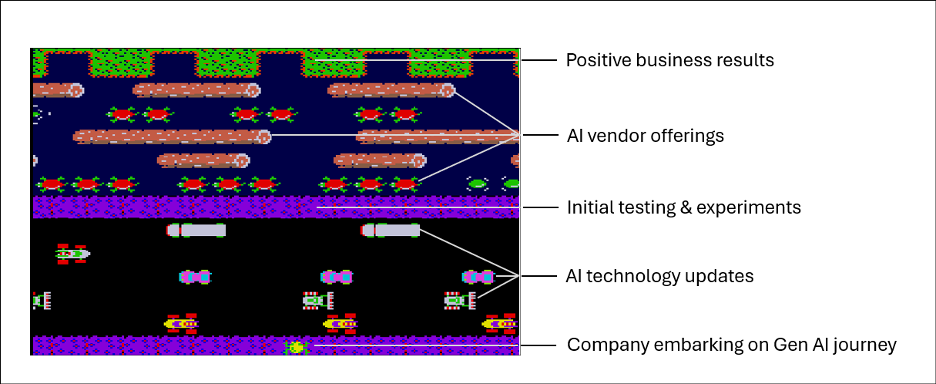
生成式AI的迅速兴起让企业内部产生了强烈的紧迫感。然而,模型的快速演进也可能让一些组织无所适从,因为形势变化太快,面对持续不断的快速变化,它们难以找准方向。采用生成式AI的秘诀,就像开始玩Frogger游戏一样:大胆加入!
从生成式AI的基本用例入手,企业确定值得尝试的用例后,即可开始试验。无论是构建AI赋能的应用、试用第三方产品,还是双管齐下,初步试验都能帮助企业明确具体的业务需求。要在这一早期阶段取得成功,关键是确定一个满足生产环境安全性和有效性要求的最低可行应用版本,以此作为企业的基础。随后,企业可以继续推进,判断哪些模型进展具有重要意义,并权衡自行构建还是采购更为审慎。
尝试采用生成式AI的组织难免会遇到两个拖慢进度的“坑”:内部训练模型和私有数据存储库。如今,基础模型以数周或数月为周期快速演进,下游版本则每天更新。要验证这一点,只需看看HuggingFace的模型追踪器。我在撰写本文时刚打开的页面上,更新时间不到1分钟的模型几乎占满了整整一页。必须向下滚动一屏,才能找到更新时间超过2分钟的模型!
如果回答AI问题所需的数据是公开的,那么很可能已经有多种合适的基础模型可通过API使用。反之,如果数据不公开,则需要决定是在推理过程中发送这些数据,还是自行构建或获取模型并进行私有化部署。与自行构建或获得许可并在内部托管和维护模型相比,付费使用模型无疑更快,而且很可能成本更低。贵公司的核心优势是什么?如果不是构建或维护大语言模型(LLM),那么更合适的选择很可能是购买服务,而不是自行构建和托管模型。
对于私有数据,LLM的上下文窗口和定制选项发展迅速,其企业级安全性与合规性已达到类似云计算现有认可标准的水平,能够满足大多数公司的要求。事实上,模型提供商在2023年已经清楚听到了这一诉求:“不使用您的数据进行训练”。以ChatGPT Enterprise为例,它宣称符合SOC 2 Type 2标准,支持SAML SSO、静态和传输中数据加密,并提供支持数据保留和域名验证的专用工作区。这些功能相当不错,对吧?对《财富》美国500强中92%的企业而言,这似乎已经足够好了。
相信生成式AI潜力的组织,无需因其固有风险或LLM日新月异的发展而裹足不前。只要充分了解相关情况并积极尝试,就有望取得成功。初期实验有助于增强信心,并确定哪些任务能在安全且合乎道德的使用方式下获得最大收益。随后,应在整个组织内将这些任务投入生产应用,为评估人员和实施人员留出调整时间,同时让组织有时间衡量生产力提升、确定下一批任务的优先级,并判断自行构建LLM与购买LLM访问服务哪种方式更合理。
关于作者

相关博客文章


2023年应用策略现状:成本与复杂性是推动多云网络发展的首要因素
多云网络解决方案可在核心、云和边缘环境之间实现无缝、安全的互联,为解决当今混合IT面临的挑战提供支持,因而备受业界关注。