有时,一项出色的技术会迎来拐点,其优势恰好契合实际业务需求。这使该技术不仅可行,而且实用。伯克利数据包过滤器(BPF)最近在Linux开发者群体中迎来了这一拐点。BPF是Linux主机上效率极高的拦截和处理点,并有望在不久后扩展到Windows服务器。它可提供海量数据,直接提升站点可靠性工程(SRE)运维任务的全栈可见性,也非常适合用于解决安全和流量管理方面的挑战。其挂钩点同样丰富,可为BPF应用提供一系列实用且颇具吸引力的触发点,满足可观测性、安全和网络专业人员的需求。BPF是以合理成本实现可观测性的合适技术,而这一切都始于可观测性。
BPF的基础设计使其成为执行计算任务时近乎尽可能高效的方法(每瓦成本)。更重要的是,工具链会自动生成字节码,让您可以专注于实现预期结果,而不必处理类似低级汇编语言的编程工作。为什么?因为以下两个设计特性让BPF脱颖而出:
指令集设计
BPF的软件设计有意借鉴了当时新兴的现代CPU架构。之所以使用处理器术语,是因为这些术语能够准确描述BPF的组成元素及其用途。BPF具有寄存器和指令,专为CPU直接执行而设计。BPF以BSD数据包过滤器设计(1992年)为基础,是一种经过重新设计的数据包捕获过滤器虚拟机,更适合当今基于寄存器的CPU架构。2014年,“增强型伯克利数据包过滤器”(Enhanced Berkeley Packet Filter),即eBPF,随Linuxv3.18版kernel发布,进一步推动了这一设计的发展。eBPF发布初期,将其与经典伯克利数据包过滤器(cBPF)区分开来十分重要。如今,所有受支持的内核版本都包含2014年引入的增强功能,因此这种区分已不再那么重要。这些增强功能仍值得关注:寄存器位宽从32位扩展到64位,可在每个缓存行或时钟周期内完成更多工作;寄存器数量从2个增加到10个,使其与现代CPU寄存器及内核ABI之间能够实现更多一一映射;此外还包括少量指令集增强功能,使BPF程序更加安全、实用。
链路层
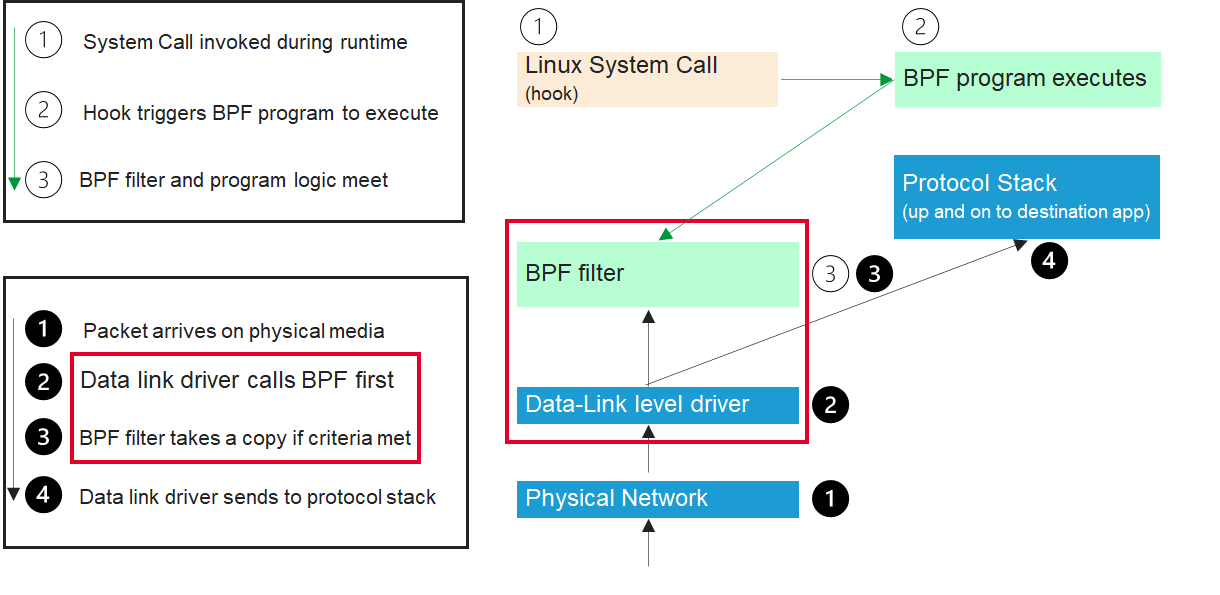
BPF由网络分流器和数据包过滤器组成。当数据包从物理线路进入指定网络接口时,分流器会在数据链路层运行。它会复制数据包,供过滤器检查。通过这一插入点,BPF可以全面查看Linux主机的网络路径。对于入站流量,该插入点位于主机处理器开始处理流量之前;对于出站流量,则位于流量即将进入物理线路并离开主机之前。此图显示BPF在数据链路层与入站数据包路径相交。
The range of available data is vast, directly adding to full stack visibility for SRE operations tasks. In this example, we focus on some of the most commonly used fields from the IPv4 header.
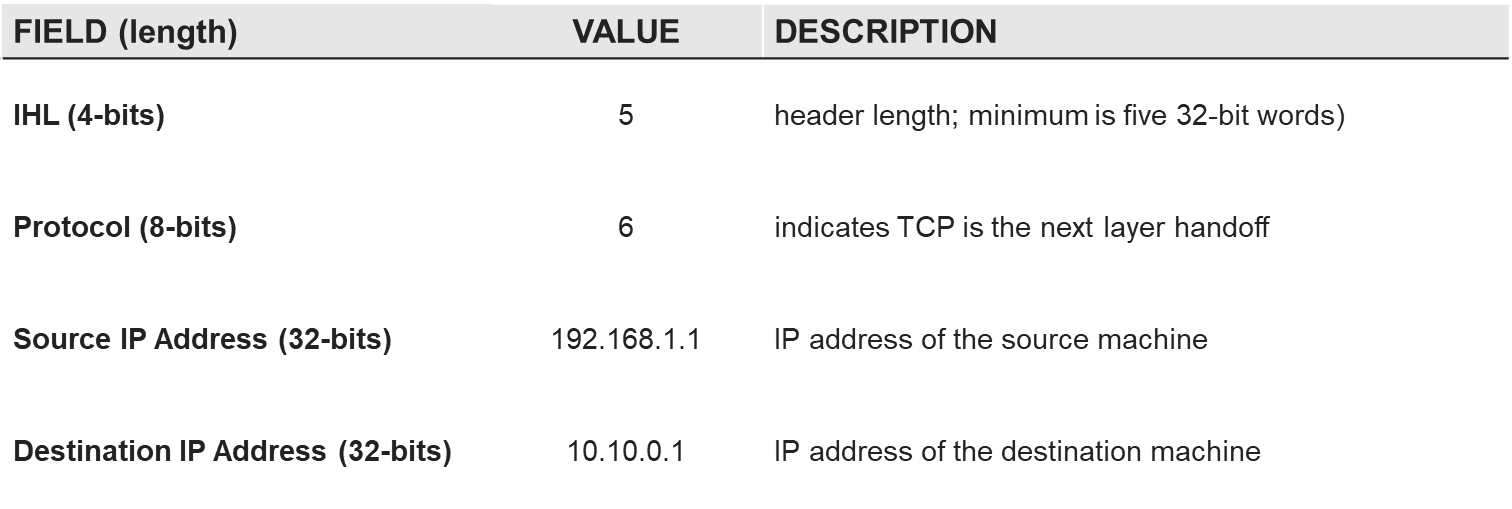
利用这些数据,可以定义策略来自定义数据包过滤。以下策略会过滤发往特定目标IP地址的TCP数据包。
利用eBPF实现可观测性可带来“一举两得”的优势:观测所得的数据不仅可用于观测,还可用于其他用途,例如流量路由或安全防护。
回到前面分享的数据集,其中用于观测Linux主机流量入站路径的部分数据还可用于其他用途。例如,源IP、目标IP、目标主机和端口既可用于入站流量路由,也可用于限制访问。
无论用于何种场景,一切都始于BPF挂接点复制数据包。复制完成后,数据可存入内存(有关BPF映射的更多信息),随后导出为遥测数据流,同时供其他指定策略和过滤操作的BPF程序使用。可观测性正是在此延伸至流量管理和安全领域。要充分发挥BPF的高效优势,首先需要明确所需的数据及其使用方式。在本系列的下一篇文章中,我的同事Muhammad Waseem Sarwar将探讨在Linux网络栈不同位置进行BPF编程的可选方案。
关于作者

相关博客文章


2023年应用策略现状:成本与复杂性是推动多云网络发展的首要因素
多云网络解决方案可在核心、云和边缘环境之间实现无缝、安全的互联,为解决当今混合IT面临的挑战提供支持,因而备受业界关注。