生成式人工智能(GenAI)已成为各方热议的话题。问题是,哪些应用正在普及?它如何让世界变得更美好?商业价值又体现在哪里?对于正在考虑是否以及何时将GenAI引入运营(AIOps)的组织而言,这些问题同样值得关注。过去一年,我持续开展生成式人工智能实验,并在F5的日常研究中广泛了解行业趋势。基于这些经验,我总结了以下五点,希望帮助相关组织了解GenAI对运营数据实践的影响,从而更好地根据现有预算、实践和文化来规划GenAI技术的采用时间。
1. GenAI模型偏爱半结构化和非结构化数据
运营数据由半结构化数据(对象)和非结构化数据集混合而成。大语言模型(LLM)能够灵活、高效地处理这些不同格式的数据,因此非常适合用于分析运营数据集。组织可以在内部开展一系列实验和评估,以验证各种支持GenAI的解决方案的有效性、易用性和成本。利用LLM推理检测值得关注的数据模式并减少误报,可以让机器的处理速度和规模更好地满足使用运营数据流的团队的目标。
2. 组织无需构建模型
如果组织专注于了解哪些模型采用了哪些技术来完成当前的特定任务,就不必自行构建模型。例如,命名实体识别(NER)是自然语言处理(NLP)的一个分支,已被证明是确定半结构化数据中关键元素的有效技术。NER的示例可以是一个列表,其中包含“星期几”之类的类别,或“大于1且小于5的整数”之类的描述。与未启用生成式AI(GenAI)的基于规则的模式匹配技术相比,这种方法可以提高推理准确性。随着NER等技术的研究和实践不断发展,运维团队可以专注于利用已证明有效的技术,而不必构建模型。
NER示例:
命名实体:星期
列表:星期日、星期一、星期二、星期三、星期四、星期五、星期六
图 1. 与基于规则的模式匹配相比,命名实体识别在推理过程中可提供更高的准确率。
3. 数据引力确实存在
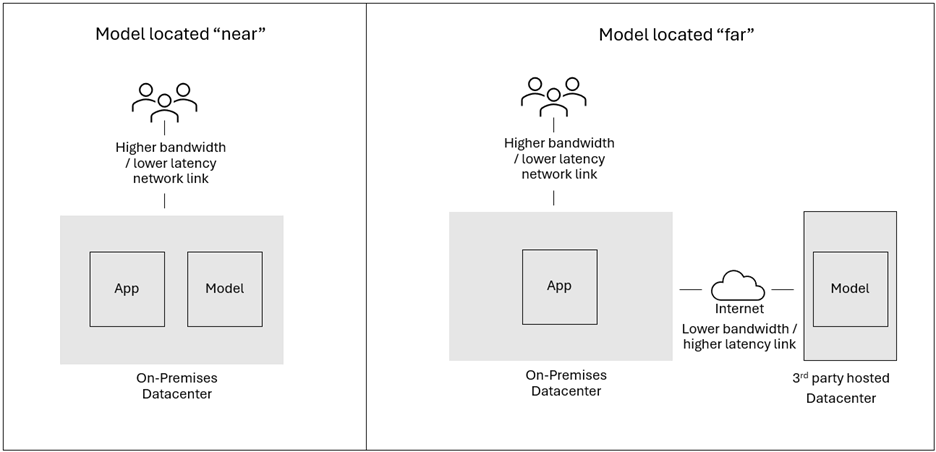
数据引力是一种潜在作用力,会影响相关决策:是将计算资源部署在更靠近数据生成位置的地方,还是将数据移至更靠近现有计算资源的位置。数据量越大,引力越强,因此需要在数据附近部署更多计算容量。训练(创建和调优模型)时,会汇聚数据并将其移至更靠近计算资源的位置。推理(使用模型)时,则会将模型移至更靠近提示词发出位置的地方。
如果访问模型的方式是将其副本部署到内部,而不是调用第三方托管实例的API,那么将模型移至更靠近提示词的位置,和/或更靠近作为提示词一部分进行向量化的其他私有数据集,是合理的做法。另一方面,如果模型由第三方托管,并通过互联网开放API,则模型和推理操作都不会移动。在这种情况下,可以通过数据中心托管互连,将推理和私有数据向量移至“网络邻近”位置;也可以在条件允许时,尝试选择与模型提供商相同的托管位置。
了解促使数据与计算资源相互靠近或彼此分离的各种因素,有助于在寻求成本与性能的适当平衡时做出明智选择。
4. 不要忽视数据孤岛,要妥善应对
随着生成式AI处理技术的应用,打破数据孤岛以简化并加快运营数据分析比以往任何时候都更加重要。然而,在可预见的未来,数据孤岛似乎仍将存在,甚至可能增多。
更关键的问题在于如何应对数据孤岛,以及如何选择技术。要访问存储在多个位置的数据,可以复制和迁移数据,也可以实施逻辑数据层,通过联合查询访问数据而无需移动数据。无论采用哪种方式,识别现有的流式数据源,并根据时间和数据新鲜度限制评估运营用例,都有助于选择数据技术栈中的必要组件,例如流处理引擎、查询引擎、数据格式和目录。技术选择让数据团队能够在平衡性能与成本的同时,选用高效且易用的技术。理想情况下,组织的数据实践会逐步成熟,同时始终保有灵活性,以便在不同成熟阶段选择最适合自身的方案。
5. 自动化是得力助手,无需畏惧
解决方案引入自动化后,可将数据隐私和安全运营(SecOps)专家的隐性知识转化为可重复、由AIOps支持且可由机器执行的实践,从而实现规模化。只有这样,数据、安全和隐私团队才能腾出精力,为相关工作融入更多智能。智能技术可更精细地定义特定数据可由谁使用、使用多长时间以及用于何种目的,同时跟踪数据的存储位置、创建了哪些副本以及与谁共享,从而提升策略的有效性。这让团队有更多时间开展战略规划、评估新技术,并与业务部门沟通,以完善数据访问策略和审批例外情况。
速度、规模和自动化是成熟AIOps实践的特征,有助于改善成果、加快决策并优化人力资本。生成式AI正在打开技术以往无法开启的大门。上述五点经验可为IT运营、安全运营和隐私运营团队提供一些指引,供其在将生成式AI引入AIOps时参考。AI模型、靠近运营数据的计算资源、数据和自动化构成了新型AIOps平台的关键要素。在这一丰富的学习环境中,组织可以构建面向当代及后续世代的技术运营文化和实践。
如需深入了解生成式AI对数据的影响,请阅读F5最新发布的《数字化企业成熟度指数》报告。
关于作者

相关博客文章


2023年应用策略现状:成本与复杂性是推动多云网络发展的首要因素
多云网络解决方案可在核心、云和边缘环境之间实现无缝、安全的互联,为解决当今混合IT面临的挑战提供支持,因而备受业界关注。