众所周知,NGINX采用异步、事件驱动的方式处理连接。这意味着,NGINX不会像采用传统架构的服务器那样,为每个请求创建单独的专用进程或线程,而是在一个工作进程中处理多个连接和请求。为此,NGINX以非阻塞模式使用套接字,并采用epoll和kqueue等高效机制。
由于重量级进程数量较少(通常每个CPU核心只有一个)且保持不变,因此内存消耗大幅降低,也不会因任务切换而浪费CPU周期。NGINX本身就是这种方法优势的典型例证。它能够成功处理数百万个并发请求,并具备出色的扩展能力。
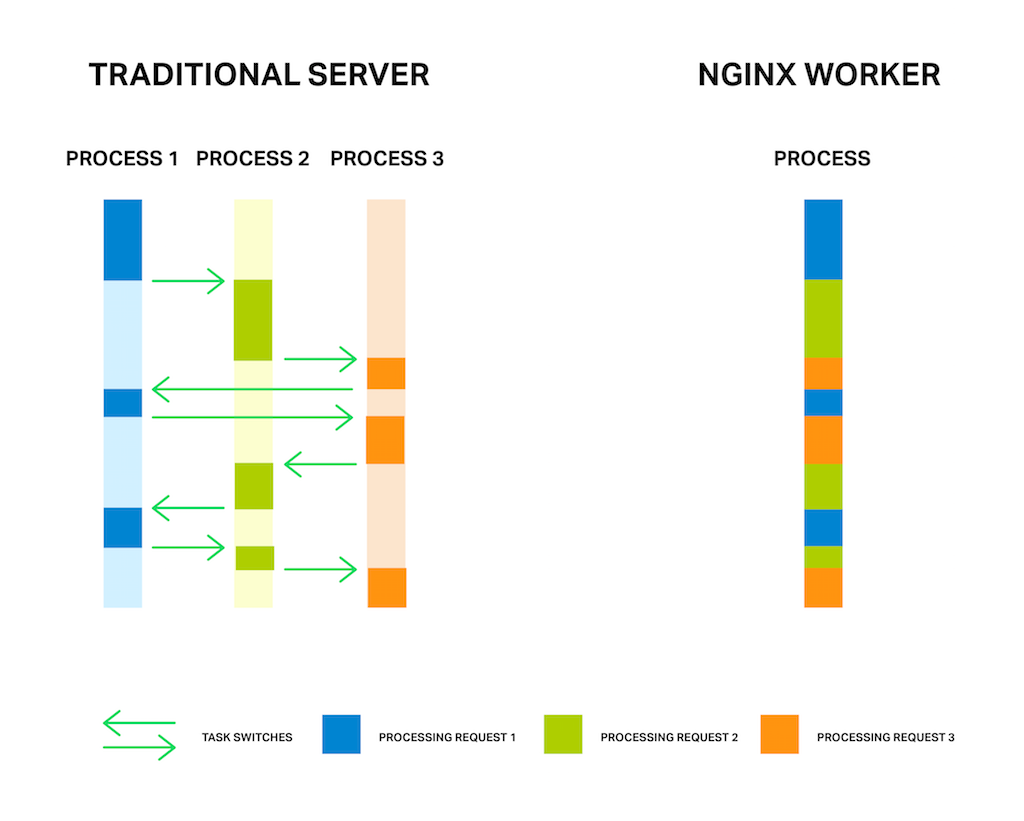
但异步事件驱动方法仍面临一个问题。或者用我习惯的说法,它有一个“敌人”。这个敌人就是:阻塞。遗憾的是,许多第三方模块会使用阻塞调用,而用户(有时甚至包括模块开发者)并不了解其弊端。阻塞操作会严重影响NGINX性能,必须尽一切可能避免。
即使在当前的NGINX官方代码中,也无法在所有情况下避免阻塞操作。为解决这一问题,NGINX引入了新的“线程池”机制,该机制已在NGINX 1.7.11版中实现,并已纳入NGINX Plus Release 7。稍后我们将介绍它是什么以及应如何使用。现在,让我们直面这个敌人。
编者注:有关NGINX Plus R7的概述,请参阅我们博客上的《NGINX Plus R7发布公告》。
有关NGINX Plus R7其他新功能的详细介绍,请参阅以下相关文章:
面临的问题
首先,为了更好地理解这个问题,先简要介绍一下NGINX的工作原理。
总体而言,NGINX是一个事件处理程序,也就是一个控制器。它从内核接收连接上发生的所有事件信息,然后向操作系统发出相应的操作指令。实际上,NGINX通过协调操作系统来完成所有复杂工作,而操作系统则负责读取和发送字节等常规工作。因此,NGINX快速、及时地响应至关重要。
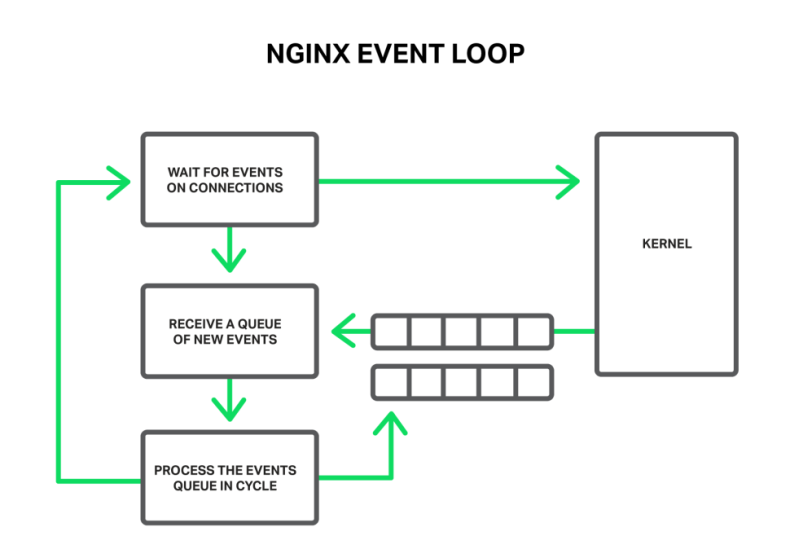
这些事件可以是超时、套接字已准备好进行读取或写入的通知,也可以是发生错误的通知。NGINX接收一批事件,然后逐一处理并执行必要的操作。因此,所有处理都由单个线程通过一个简单的循环遍历队列来完成。NGINX从队列中取出一个事件,然后作出相应处理,例如写入或读取套接字。在大多数情况下,这一过程非常快(可能只需几个CPU周期即可在内存中复制一些数据),NGINX可以瞬间处理完队列中的所有事件。
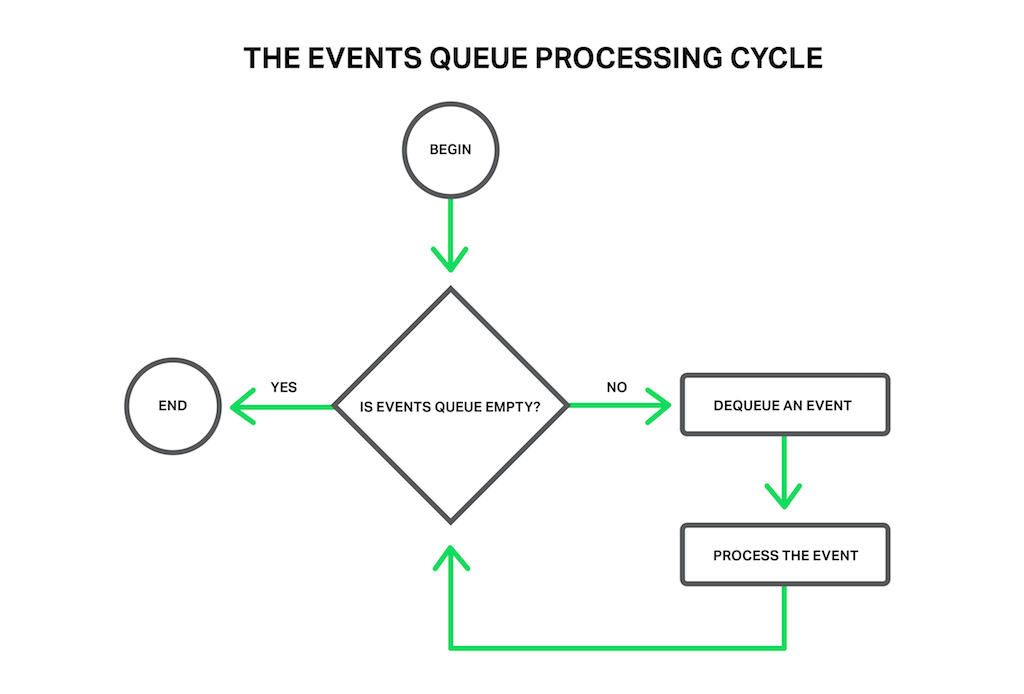
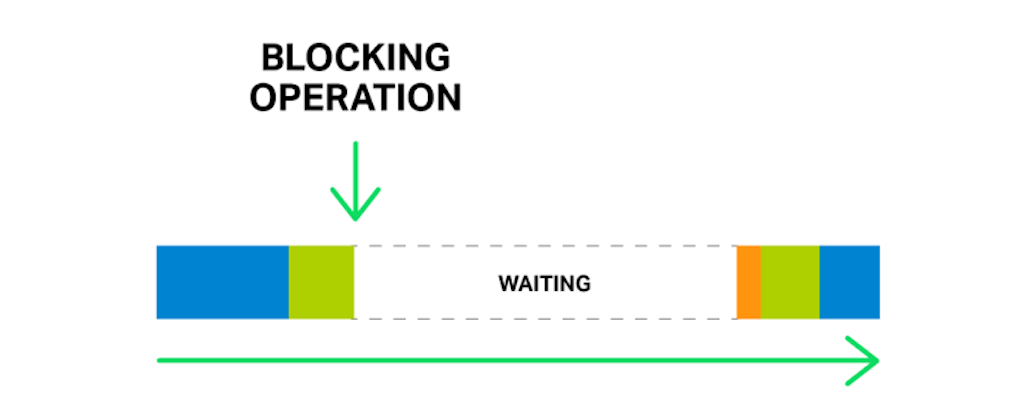
但如果出现耗时且繁重的操作,会发生什么?整个事件处理周期都会停滞,等待该操作完成。
因此,“阻塞操作”是指任何会使事件处理循环长时间停滞的操作。操作可能因多种原因而发生阻塞。例如,NGINX可能正忙于执行耗时且占用大量CPU资源的处理,也可能必须等待访问某项资源(例如硬盘、互斥锁,或以同步方式从数据库获取响应的库函数调用等)。关键在于,工作进程在处理此类操作时无法执行任何其他任务,也无法处理其他事件,即使系统还有更多可用资源,并且队列中的某些事件可以利用这些资源。
假设一家商店里有一名销售员,面前排着长队。排在最前面的顾客想要一件店内没有、但仓库里有的商品。销售员于是前往仓库取货。现在,整支队伍都必须等待几个小时,直到他取货回来,队伍里的每个人都很不满。可以想象大家会有什么反应。每个人都要多等几个小时,但他们想买的商品可能就在店里。
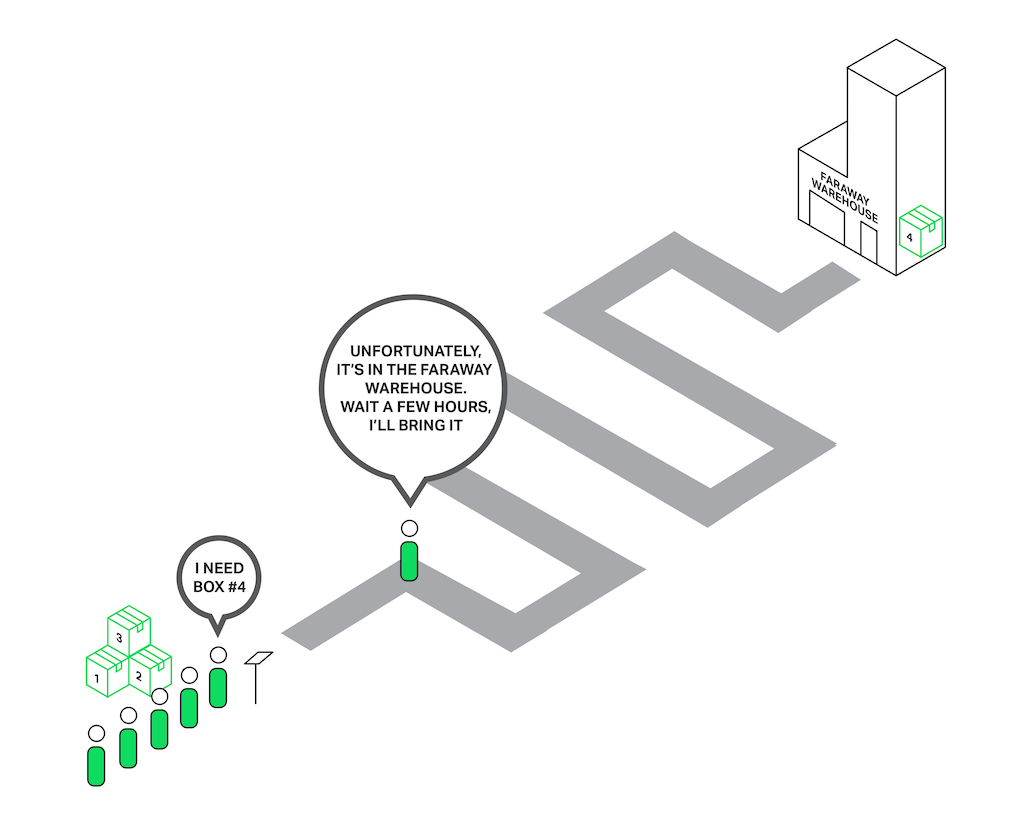
当NGINX请求读取未缓存在内存中、必须从磁盘读取的文件时,也会出现几乎相同的情况。硬盘速度较慢(尤其是机械硬盘)。队列中等待的其他请求即使可能不需要访问硬盘,也不得不继续等待。因此,延迟会增加,系统资源也无法得到充分利用。
一些操作系统提供用于读取和发送文件的异步接口,NGINX可以使用此接口(请参阅aio指令)。FreeBSD就是一个很好的例子。遗憾的是,Linux的情况并非如此。虽然Linux提供了某种用于读取文件的异步接口,但它存在几个明显的缺点。其中之一是文件访问和缓冲区必须满足对齐要求,不过NGINX可以妥善处理这一问题。第二个问题则更为严重。该异步接口要求在文件描述符上设置O_DIRECT标志,这意味着对文件的任何访问都会绕过内存缓存,并增加硬盘负载。因此,它显然不适合许多使用场景。
为解决这一特定问题,NGINX 1.7.11和NGINX Plus Release 7引入了线程池。
下面深入了解线程池是什么,以及它们的工作原理。
线程池
让我们回到那位可怜的销售助理身上,他需要从遥远的仓库取货。不过,他现在变聪明了(也许是被一群愤怒的客户揍过之后才开窍的?),于是雇了一家配送服务商。现在,如果有人需要远处仓库里的商品,他不再亲自前往仓库,而是直接向配送服务商下单,由对方处理订单,自己则继续接待其他客户。这样一来,只有所需商品不在店内的客户需要等待配送,其他客户都能立即得到服务。
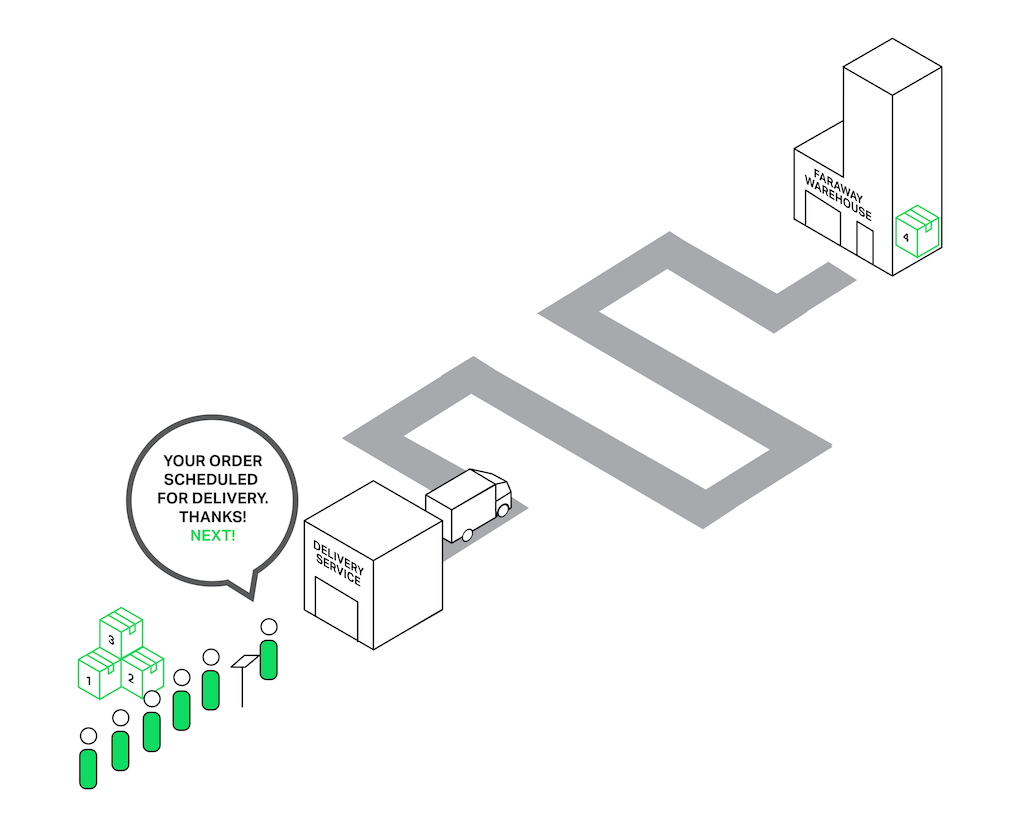
对于NGINX而言,线程池承担配送服务的功能。它由一个任务队列和若干处理该队列的线程组成。当工作进程需要执行可能耗时较长的操作时,不会自行处理,而是将任务放入线程池的队列中,由任一空闲线程取出并处理。
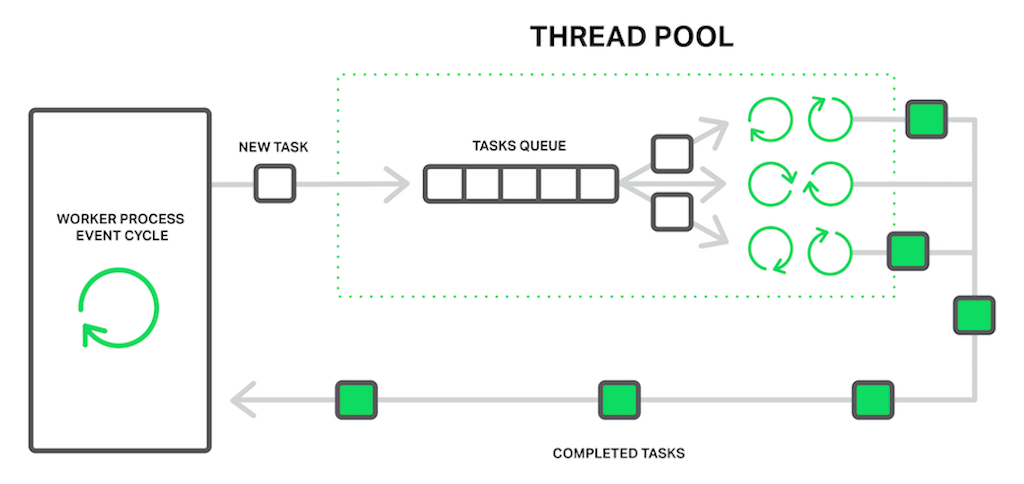
这样看来,我们又多了一个队列。没错,但在这种情况下,队列受特定资源的限制。我们从驱动器读取数据的速度无法超过驱动器提供数据的速度。这样一来,驱动器至少不会延迟其他事件的处理,只有需要访问文件的请求才会等待。
“从磁盘读取”操作通常被用作阻塞操作的典型示例,但实际上,NGINX中的线程池实现可用于处理任何不适合在主工作循环中执行的任务。
目前,仅有三项基本操作实现了向线程池卸载:大多数操作系统上的read()系统调用、Linux上的sendfile(),以及Linux上的aio_write(),后者用于写入某些临时文件,例如缓存临时文件。我们将继续对该实现进行测试和基准评估;如果其他操作向线程池卸载确有明显优势,未来版本中可能也会这样处理。
编者注:对 aio_write() 系统调用的支持已添加到NGINX 1.9.13和NGINX Plus R9中。
基准测试
现在是从理论转向实践的时候了。为了展示使用线程池的效果,我们将进行一项综合基准测试,模拟阻塞操作与非阻塞操作最糟糕的混合情况。
这需要一个确定无法全部载入内存的数据集。我们在一台配备 48 GB 内存的计算机上生成了 256 GB 的随机数据,并将其拆分为多个 4 MB 文件,然后配置 NGINX 1.9.0 来提供这些数据。
配置非常简单:
worker_processes 16;
events {
    accept_mutex off;
}

http {
    include mime.types;
    default_type application/octet-stream;

    access_log off;
    sendfile on;
    sendfile_max_chunk 512k;

    server {
        listen 8000;

        location / {
            root /storage;
        }
    }
}可以看到,为提升性能,已进行以下调优:已禁用logging和accept_mutex,已启用sendfile,并设置了sendfile_max_chunk。最后一项指令可以缩短阻塞式sendfile()调用所占用的最长时间,因为NGINX不会尝试一次发送整个文件,而是将文件分成512 KB的数据块发送。
该计算机配备两颗Intel Xeon E5645处理器(共12个核心、24个超线程)和一个10 Gbps网络接口。磁盘子系统由4块Western Digital WD1003FBYX硬盘组成,并配置为RAID10阵列。所有这些硬件均运行Ubuntu Server 14.04.1 LTS。
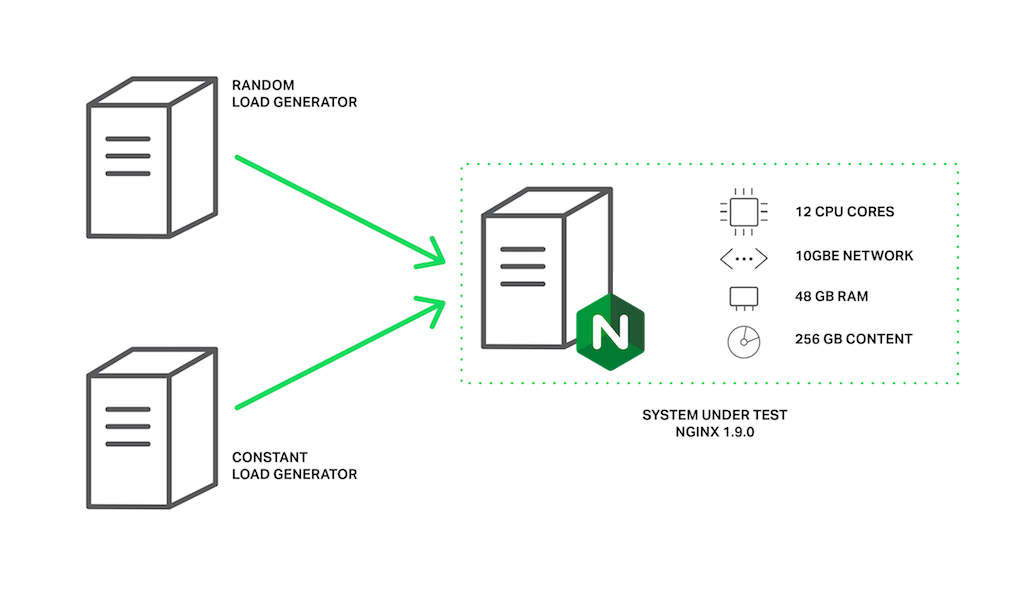
客户端由两台配置相同的计算机模拟。其中一台计算机使用wrk通过Lua脚本生成负载。该脚本使用200个并行连接,以随机顺序从服务器请求文件,每个请求都可能导致缓存未命中,并阻塞等待从磁盘读取数据。我们将这种负载称为随机负载。
在第二台客户端计算机上,我们将运行另一个wrk实例,通过50个并行连接多次请求同一文件。由于该文件会被频繁访问,因此将始终驻留在内存中。正常情况下,NGINX会非常快速地处理这些请求;但如果工作进程被其他请求阻塞,性能就会下降。我们将这种负载称为恒定负载。
性能将通过以下方式衡量:使用ifstat监控服务器计算机的吞吐量,并从第二台客户端获取wrk的结果。
现在,首次在不使用线程池的情况下运行,结果并不理想:
% ifstat -bi eth2eth2
Kbps in  Kbps out
5531.24  1.03e+06
4855.23  812922.7
5994.66  1.07e+06
5476.27  981529.3
6353.62  1.12e+06
5166.17  892770.3
5522.81  978540.8
6208.10  985466.7
6370.79  1.12e+06
6123.33  1.07e+06
可以看到,采用此配置时,服务器总共可产生约1 Gbps的流量。从top的输出中可以看到,所有工作进程大部分时间都处于阻塞I/O状态(即处于D状态):
top - 10:40:47 up 11 days,  1:32,  1 user,  load average: 49.61, 45.77 62.89Tasks: 375 total,  2 running, 373 sleeping,  0 stopped,  0 zombie
%Cpu(s):  0.0 us,  0.3 sy,  0.0 ni, 67.7 id, 31.9 wa,  0.0 hi,  0.0 si,  0.0 st
KiB Mem:  49453440 total, 49149308 used,   304132 free,    98780 buffers
KiB Swap: 10474236 total,    20124 used, 10454112 free, 46903412 cached Mem

  PID USER     PR  NI    VIRT    RES     SHR S  %CPU %MEM    TIME+ COMMAND
 4639 vbart    20   0   47180  28152     496 D   0.7  0.1  0:00.17 nginx
 4632 vbart    20   0   47180  28196     536 D   0.3  0.1  0:00.11 nginx
 4633 vbart    20   0   47180  28324     540 D   0.3  0.1  0:00.11 nginx
 4635 vbart    20   0   47180  28136     480 D   0.3  0.1  0:00.12 nginx
 4636 vbart    20   0   47180  28208     536 D   0.3  0.1  0:00.14 nginx
 4637 vbart    20   0   47180  28208     536 D   0.3  0.1  0:00.10 nginx
 4638 vbart    20   0   47180  28204     536 D   0.3  0.1  0:00.12 nginx
 4640 vbart    20   0   47180  28324     540 D   0.3  0.1  0:00.13 nginx
 4641 vbart    20   0   47180  28324     540 D   0.3  0.1  0:00.13 nginx
 4642 vbart    20   0   47180  28208     536 D   0.3  0.1  0:00.11 nginx
 4643 vbart    20   0   47180  28276     536 D   0.3  0.1  0:00.29 nginx
 4644 vbart    20   0   47180  28204     536 D   0.3  0.1  0:00.11 nginx
 4645 vbart    20   0   47180  28204     536 D   0.3  0.1  0:00.17 nginx
 4646 vbart    20   0   47180  28204     536 D   0.3  0.1  0:00.12 nginx
 4647 vbart    20   0   47180  28208     532 D   0.3  0.1  0:00.17 nginx
 4631 vbart    20   0   47180    756     252 S   0.0  0.1  0:00.00 nginx
 4634 vbart    20   0   47180  28208     536 D   0.0  0.1  0:00.11 nginx< 4648 vbart 20 0 25232 1956 1160 R 0.0 0.0 0:00.08 top
25921 vbart    20   0  121956   2232    1056 S   0.0  0.0  0:01.97 sshd
25923 vbart 20 0 40304 4160 2208 S 0.0 0.0 0:00.53 zsh在这种情况下,吞吐量受磁盘子系统限制,而CPU大部分时间处于空闲状态。wrk的测试结果也很低:
Running 1m test @ http://192.0.2.1:8000/1/1/1  12 threads and 50 connections
  Thread Stats   Avg    Stdev     Max  +/- Stdev
    Latency     7.42s  5.31s   24.41s   74.73%
    Req/Sec     0.15    0.36     1.00    84.62%
  488 requests in 1.01m, 2.01GB read
Requests/sec:      8.08
Transfer/sec:     34.07MB
请注意,这里测试的是本应从内存提供的文件!延迟之所以异常高,是因为所有工作进程都忙于从磁盘读取文件,以处理第一个客户端通过200个连接产生的随机负载,因而无法及时处理我们的请求。
现在该启用线程池了。为此,只需将aio threads指令添加到location块中:
location / {    root /storage;
    aio threads;
}
并让NGINX重新加载其配置。
之后,我们重复测试:
% ifstat -bi eth2eth2
Kbps in  Kbps out
60915.19  9.51e+06
59978.89  9.51e+06
60122.38  9.51e+06
61179.06  9.51e+06
61798.40  9.51e+06
57072.97  9.50e+06
56072.61  9.51e+06
61279.63  9.51e+06
61243.54  9.51e+06
59632.50 9.50e+06现在,我们的服务器吞吐量达到9.5 Gbps,而未使用线程池时约为1 Gbps!
它或许还能实现更高的吞吐量,但目前已经达到网络容量的实际极限,因此在本次测试中,NGINX的性能受限于网络接口。工作进程大部分时间都处于休眠状态,等待新事件(在S状态下显示于top中):
top - 10:43:17 up 11 days,  1:35,  1 user,  load average: 172.71, 93.84, 77.90Tasks: 376 total,  1 running, 375 sleeping,  0 stopped,  0 zombie
%Cpu(s):  0.2 us,  1.2 sy,  0.0 ni, 34.8 id, 61.5 wa,  0.0 hi,  2.3 si,  0.0 st
KiB Mem:  49453440 total, 49096836 used,   356604 free,    97236 buffers
KiB Swap: 10474236 total,    22860 used, 10451376 free, 46836580 cached Mem

  PID USER     PR  NI    VIRT    RES     SHR S  %CPU %MEM    TIME+ COMMAND
 4654 vbart    20   0  309708  28844     596 S   9.0  0.1  0:08.65 nginx
 4660 vbart    20   0  309748  28920     596 S   6.6  0.1  0:14.82 nginx
 4658 vbart    20   0  309452  28424     520 S   4.3  0.1  0:01.40 nginx
 4663 vbart    20   0  309452  28476     572 S   4.3  0.1  0:01.32 nginx
 4667 vbart    20   0  309584  28712     588 S   3.7  0.1  0:05.19 nginx
 4656 vbart    20   0  309452  28476     572 S   3.3  0.1  0:01.84 nginx
 4664 vbart    20   0  309452  28428     524 S   3.3  0.1  0:01.29 nginx
 4652 vbart    20   0  309452  28476     572 S   3.0  0.1  0:01.46 nginx
 4662 vbart    20   0  309552  28700     596 S   2.7  0.1  0:05.92 nginx
 4661 vbart    20   0  309464  28636     596 S   2.3  0.1  0:01.59 nginx
 4653 vbart    20   0  309452  28476     572 S   1.7  0.1  0:01.70 nginx
 4666 vbart    20   0  309452  28428     524 S   1.3  0.1  0:01.63 nginx
 4657 vbart    20   0  309584  28696     592 S   1.0  0.1  0:00.64 nginx
 4655 vbart    20   0  30958   28476     572 S   0.7  0.1  0:02.81 nginx
 4659 vbart    20   0  309452  28468     564 S   0.3  0.1  0:01.20 nginx
 4665 vbart    20   0  309452  28476     572 S   0.3  0.1  0:00.71 nginx 5180 vbart 20 0 25232 1952 1156 R 0.0 0.0 0:00.45 top
 4651 vbart    20   0   20032    752     252 S   0.0  0.0  0:00.00 nginx
25921 vbart    20   0  121956   2176    1000 S   0.0  0.0  0:01.98 sshd
25923 vbart    20   0   40304   3840    2208 S   0.0  0.0  0:00.54 zsh
CPU资源仍然十分充足。
The results of wrk 的结果:
Running 1m test @ http://192.0.2.1:8000/1/1/1  12 threads and 50 connections
  Thread Stats   Avg      Stdev     Max  +/- Stdev
    Latency   226.32ms  392.76ms   1.72s   93.48%
    Req/Sec    20.02     10.84    59.00    65.91%
  15045 requests in 1.00m, 58.86GB read
Requests/sec:    250.57
Transfer/sec:      0.98GB
提供一个4 MB文件的平均用时已从7.42秒缩短至226.32毫秒(缩短至约1/33),每秒请求数则提升至原来的31倍(250比8)!
原因在于,当工作进程因读取操作而阻塞时,请求不再进入事件队列等待处理,而是由空闲线程处理。当磁盘子系统尽其所能处理来自第一台客户端计算机的随机负载时,NGINX会利用其余CPU资源和网络容量,从内存中响应第二台客户端的请求。
仍非万能之策
在了解了阻塞操作的种种隐患,又看到了一些令人振奋的结果后,可能大多数人已经准备在服务器上配置线程池了。先别急。
事实上,所幸大多数文件读取和发送操作并不需要直接访问速度较慢的硬盘。如果有足够的RAM存储数据集,操作系统就能将常用文件缓存在所谓的“页缓存”中。
页面缓存的效果相当不错,使NGINX在几乎所有常见用例中都能展现出出色的性能。从页面缓存读取数据非常快,因此这类操作不能称为“阻塞”操作。另一方面,将操作卸载到线程池会产生一定的开销。
因此,如果RAM容量充足且工作数据集不大,那么即使不使用线程池,NGINX也已能以非常高效的方式运行。
将读取操作卸载到线程池是一项适用于特定任务的技术。当频繁请求的内容量超出操作系统VM缓存的容量时,这项技术最为实用。例如,高负载的NGINX流媒体服务器就可能属于这种情况。我们的基准测试模拟的正是这一场景。
如果能改进将读取操作卸载到线程池的方式,将会非常有帮助。我们只需要一种高效的方法来判断所需的文件数据是否在内存中;只有不在内存中时,才应将读取操作卸载到单独的线程。
回到前面的销售类比,目前销售员无法知道客户所需的商品是否在店内,因此只能选择始终将所有订单交给配送服务处理,或始终由自己处理。
问题在于操作系统缺少这项功能。早在2010年,就有人首次尝试将其作为fincore()系统调用添加到Linux中,但未能实现。后来又多次尝试将其实现为带有preadv2()标志的新RWF_NONBLOCK系统调用(详情请参阅LWN.net上的《非阻塞缓冲文件读取操作》和《异步缓冲读取操作》)。这些补丁最终能否被接受,目前仍不明确。遗憾的是,这些补丁至今未被内核接受,主要原因似乎是持续不断的无休止争论。
另一方面,FreeBSD用户完全不必担心。FreeBSD已经提供了足够完善的文件异步读取接口,建议使用该接口,而不是线程池。
配置线程池
因此,如果您确定在自己的用例中使用线程池可以带来一定收益,就可以开始深入了解相关配置。
配置非常简单灵活。首先,需要使用NGINX 1.7.11或更高版本,并在编译时为--with-threads命令指定configure参数。NGINX Plus用户需要使用Release 7或更高版本。在最简单的情况下,配置十分简洁,只需在适当的上下文中添加aio threads指令:
# in the 'http', 'server', or 'location' contextaio threads;这是线程池可采用的最简配置。实际上,它是以下配置的简写形式:
# in the 'main' contextthread_pool default threads=32 max_queue=65536;

# in the 'http', 'server', or 'location' context
aio threads=default;它定义了一个名为“default”的线程池,其中包含32个工作线程,任务队列最多可容纳65,536个任务。如果任务队列过载,NGINX会拒绝请求并记录以下错误:
thread pool "NAME" queue overflow: N tasks waiting此错误表示,线程处理任务的速度可能跟不上任务加入队列的速度。可以尝试增大队列的最大容量;如果仍无法解决问题,则说明系统无法处理如此多的请求。
如您所见,使用thread_pool指令可以配置线程数、队列的最大长度以及特定线程池的名称。最后一项意味着,您可以配置多个相互独立的线程池,并在配置文件的不同位置使用它们,以满足不同需求:
# in the 'main' context
thread_pool one threads=128 max_queue=0;
thread_pool two threads=32;

http {
    server {
        location /one {
            aio threads=one;
        }

        location /two {
            aio threads=two;
        }

    }
    # ...
}如果未指定max_queue参数,则默认使用值 65536。如上所示,可以将max_queue设置为零。在这种情况下,线程池只能处理与所配置线程数相同数量的任务;不会有任务在队列中等待。
现在,假设有一台配备3块硬盘的服务器,并希望将其用作“缓存代理”,缓存来自所有后端的响应。预计缓存的数据量远超可用RAM。实际上,这是一台用于个人CDN的缓存节点。在这种情况下,最重要的当然是充分发挥硬盘性能。
一种选择是配置RAID阵列。这种方法各有利弊。现在,借助NGINX,还可以采用另一种方法:
# We assume that each of the hard drives is mounted on one of these directories:# /mnt/disk1, /mnt/disk2, or /mnt/disk3

# in the 'main' context
thread_pool pool_1 threads=16;
thread_pool pool_2 threads=16;
thread_pool pool_3 threads=16;

http {
    proxy_cache_path /mnt/disk1 levels=1:2 keys_zone=cache_1:256m max_size=1024G
                     use_temp_path=off;
    proxy_cache_path /mnt/disk2 levels=1:2 keys_zone=cache_2:256m max_size=1024G
                     use_temp_path=off;
    proxy_cache_path /mnt/disk3 levels=1:2 keys_zone=cache_3:256m max_size=1024G
                     use_temp_path=off;

    split_clients $request_uri $disk {
        33.3%     1;
        33.3%     2;
        *         3;
    }

    server {
        # ...
        location / {
            proxy_pass http://backend;
            proxy_cache_key $request_uri;
            proxy_cache cache_$disk;
            aio threads=pool_$disk;
            sendfile on;
        }
    }
}在此配置中,thread_pool指令为每个磁盘定义一个专用的独立线程池,proxy_cache_path指令则在每个磁盘上定义一个专用的独立缓存。
使用split_clients模块在各缓存之间(进而在各磁盘之间)进行负载均衡,非常适合此任务。
The use_temp_path=off 参数指示 proxy_cache_path 指令让NGINX将临时文件保存到相应缓存数据所在的同一目录中。更新缓存时,需要使用此参数来避免在硬盘之间复制响应数据。
这些措施共同作用,可充分发挥当前磁盘子系统的性能,因为NGINX通过不同的线程池与各个驱动器并行且独立地交互。每个驱动器由16个独立线程处理,并配有专用任务队列,用于读取和发送文件。
相信您的客户会喜欢这种量身定制的方法。也请确保硬盘同样适用。
此示例充分展示了如何针对特定硬件灵活调优NGINX。这就像是在指示NGINX以适当的方式与计算机和数据集交互。通过在用户空间中精细调优NGINX,可以让软件、操作系统和硬件以更合适的模式协同工作,从而尽可能有效地利用所有系统资源。
总结
总而言之,线程池是一项出色的功能,它消除了长期以来影响NGINX性能的一个常见问题,即阻塞,从而将NGINX的性能提升到新的水平,尤其是在处理海量内容时。
未来还会有更多可能。如前所述,这一全新接口有望在不损失性能的情况下,将任何耗时较长的阻塞操作卸载出去。借助大量新模块和新功能,NGINX将开辟新的发展空间。许多常用库仍未提供异步非阻塞接口,因此过去无法与NGINX兼容。我们可以投入大量时间和资源,为某个库自行开发非阻塞原型,但这样的投入是否总是值得?现在有了线程池,就可以相对轻松地使用这类库,并在不影响性能的情况下开发相应模块。
敬请关注。
亲自体验NGINX Plus中的线程池,立即开始30天免费试用,或联系我们,讨论您的用例。
相关博客文章

NGINX Plus R26 正式发布
NGINX Plus R26通过缓存JSON Web密钥集加快JWT验证,并强化TLS握手,从而提升安全性。NGINX JavaScript的新功能包括增强对异步函数的支持,以及实现WebCrypto API。
使用NGINX App Protect DoS保护gRPC应用,抵御严重的DoS攻击
gRPC具备开发人员设计和部署现代应用所需的速度与灵活性,但其开放性也使其极易受到第7层DoS攻击。NGINX App Protect DoS可保护gRPC应用免受此类破坏性攻击。
Ingress Controller 选型指南(第 2 部分):风险与面向未来的规划
了解选择错误的Ingress控制器可能带来的风险,以及如何从关键方面着手,让您的选择更好地适应未来需求。
NGINX Plus R19 正式发布
NGINX Plus R19扩展了监控功能,不仅提供更多指标,还新增了指标分析方式;增加试运行模式,用于测试限速效果;增强键值存储,以支持IP地址范围;并使限速更加动态。
NGINX现已正式加入F5
NGINX现已正式成为F5的一部分。Gus Robertson现任F5 NGINX业务部门负责人。他阐述了两家公司在人才、文化和愿景方面融合的价值,以及双方将如何携手增强NGINX的开源产品和商业产品。
