“这是一场完美风暴”或许是常见的说法,但用来形容云计算成本失控却十分贴切。多种因素相互叠加,最终形成了这场风暴:
- 部署工作负载的人员并非为其付费的人员
- 可以轻松按需以编程方式使用基础设施
- 借助易于访问的代码存储库,可以从他人编写的现有代码中“借用”功能
- CI/CD流水线和SRE实践有助于开发人员快速集成和部署代码
综合来看,开发人员往往会利用现有代码块快速部署新功能,但这些代码通常并未针对其在新应用中的用途进行精简或优化。由于产品上市速度至关重要,优化工作只能退居次要位置(而且是非常次要的位置)。如果未经优化的代码影响性能,只需调用API,即可配置性能更强的基础设施。问题解决了!
更让问题雪上加霜的是,编写代码的人员与支付账单的人员在思维方式和组织架构上存在隔阂。随着企业云成本不断上升,首席财务官倍感压力。然而,导致云账单增加的开发人员却因快速交付产品而受到奖励,对这种激励机制所造成的后续财务问题浑然不觉。
为解决这一问题,F5 NGINX与Opsani携手推出了一套优化解决方案,让F5 NGINX Ingress Controller订阅用户能够从现有部署中获得更多收益。将Opsani Servo container部署到KubeNest工作负载后,NGINX Ingress Controller即可成为经过优化的解决方案,并利用Prometheus收集速率、错误和持续时间(RED)指标。Opsani利用由机器学习驱动的自主优化功能,持续优化基础设施,确保资源用量合理,从而提高性能并降低成本。
利用云优化降低成本
NGINX用户已经熟悉降低云成本的基本方法:使用轻量级工具,在提供高速性能的同时,尽可能减少额外延迟。当然,在Kubernetes环境中,简单而强大的工具也是成功部署的必要条件。本文将介绍如何利用以下三种工具,在降低成本的同时提升性能:
- NGINX Ingress Controller,一款基于F5 NGINX Plus的Ingress控制器。由于无需事件处理程序或重新加载配置,即可动态适应后端端点的变化,其性能显著优于其他基于NGINX的Ingress控制器。
- Opsani:一种独特的持续优化即服务(COaaS)解决方案,可将持续优化(CO)添加到CI/CD流水线中,帮助您快速交付代码,并对代码进行优化,以较低的成本实现出色性能。
- Prometheus:一个广受欢迎的开源监控和告警项目。借助NGINX Plus Prometheus module,基于NGINXnbsp;Plus的NGINX Ingress Controller可将数百项指标导出到Prometheus服务器。
基于NGINX Plus的NGINX Ingress Controller版本有一项非常强大的用例,即通过提高Kubernetes中的可观测性实时监控(通过NGINX Plus仪表盘)和历史数据(通过Prometheus)来实现这一目标。此外,作为工作负载的前端,NGINX Ingress Controller可以收集速率、错误和持续时间(RED)指标,并通过Prometheus将这些指标传送至Opsani。Opsani利用机器学习将这些指标与当前部署的基础设施相关联,并建议进行相应更改,以优化NGINX Ingress Controller、应用或整个技术栈。还可以配置Opsani,使其在达到为NGINX Ingress Controller设置的延迟和性能阈值时发出警报。
数据一览:优化测试结果
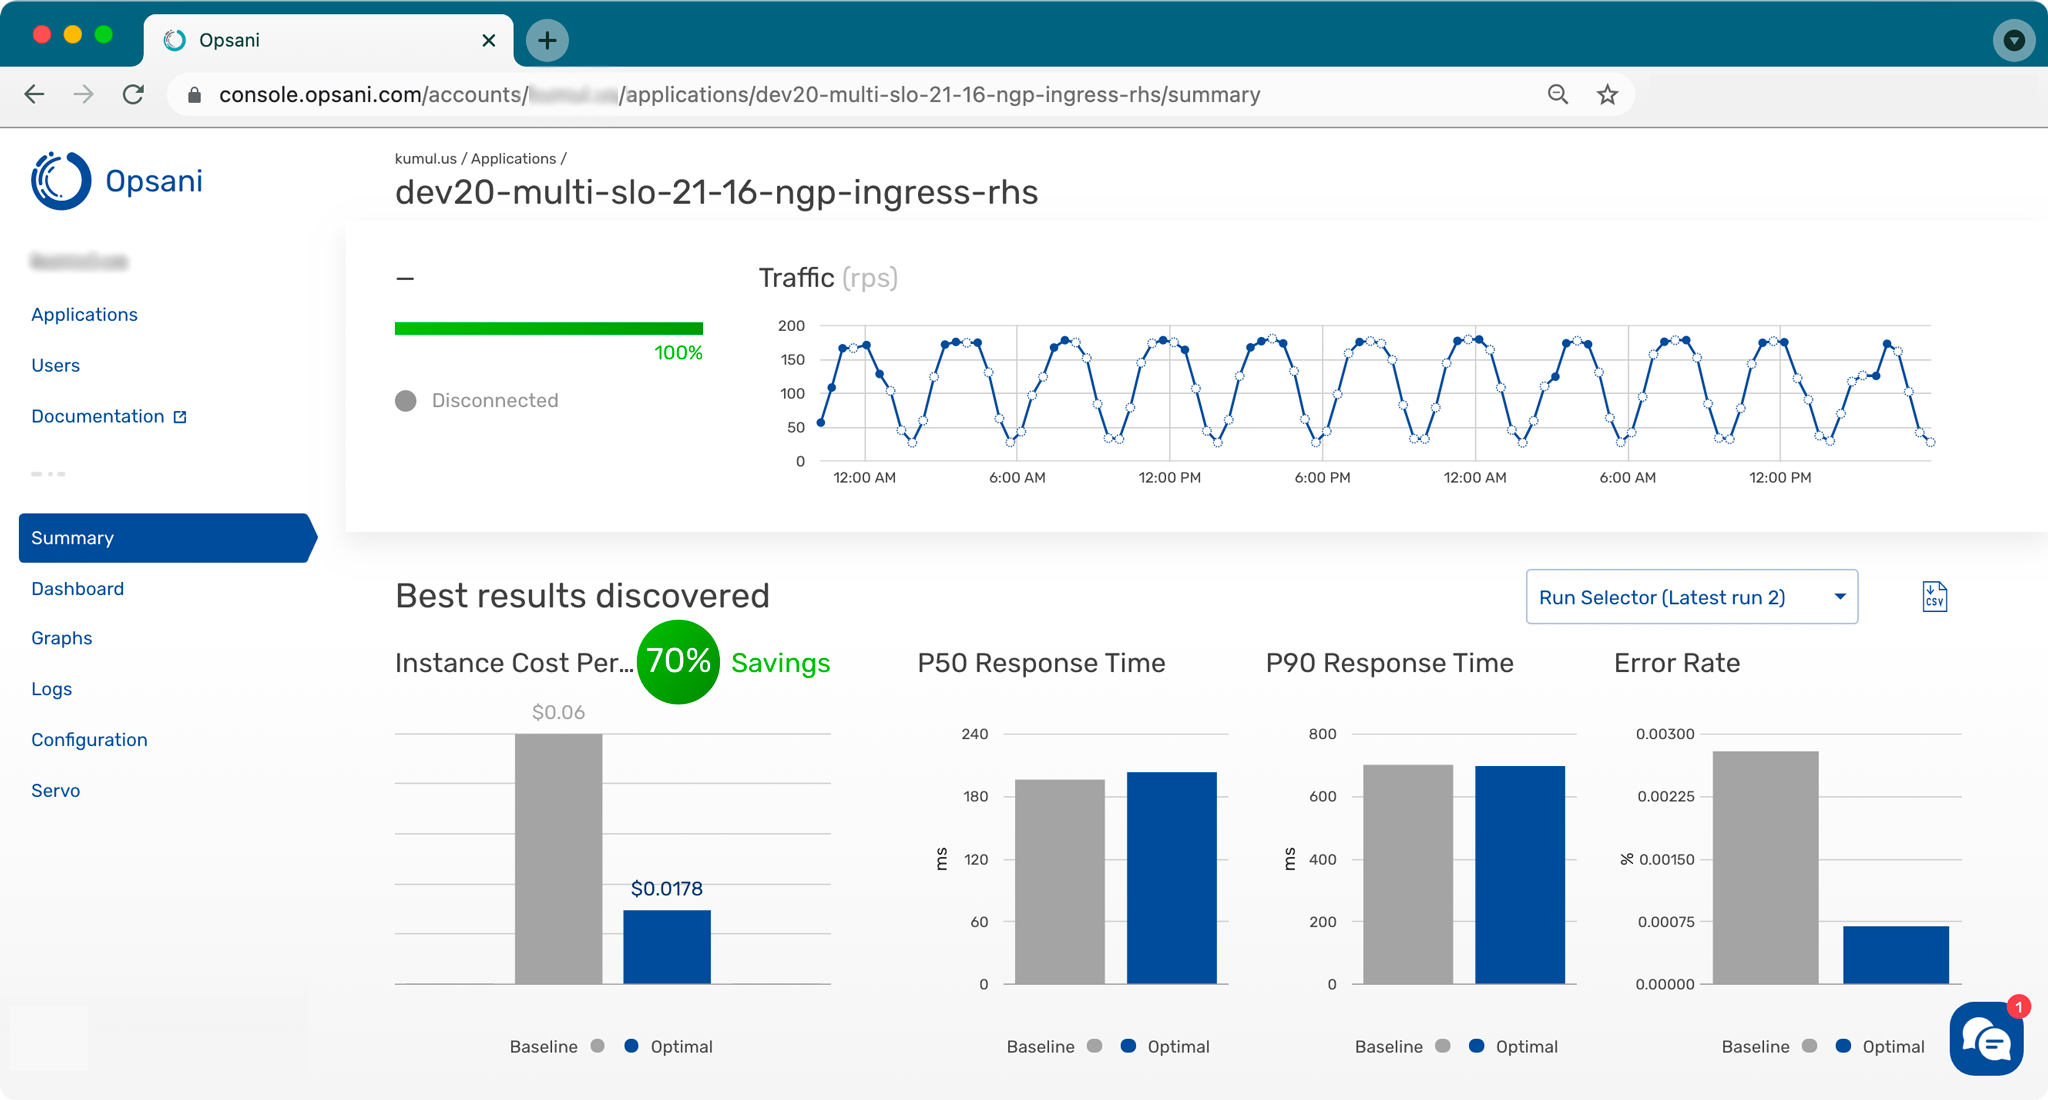
下面通过一个示例,了解部署基于NGINX Plus的NGINX Ingress Controller并结合使用Opsani和Prometheus后可获得的效果。如截图所示,Opsani的“摘要”页面会显示一段时间内的流量(每秒请求数,即RPS),并重点展示其优化相较于基准设置带来的优势。在本例中,“每小时实例成本”节省了70%,“P50响应时间”缩短了5%。
我们想了解这些结果与一款广为人知的Ingress控制器相比表现如何,即由Kubernetes社区维护、基于NGINX Open Source的Ingress控制器,其GitHub仓库为kubernetes/ingress-nginx。(按照既定的NGINX惯例,本文后续将其称为“社区Ingress控制器”。基于NGINX Plus的NGINX Ingress Controller由NGINX工程团队维护,其GitHub仓库为nginxinc/kubernetes-ingress;该仓库还包含其姊妹产品,即基于NGINX Open Source的NGINX Ingress Controller。)
我们测试了这两种Ingress控制器在三种拓扑结构下的性能:
- 拓扑 1:社区版Ingress控制器,使用标准流程部署。通过在应用Pod的边车容器中添加与被测应用串联的Envoy代理来收集指标。
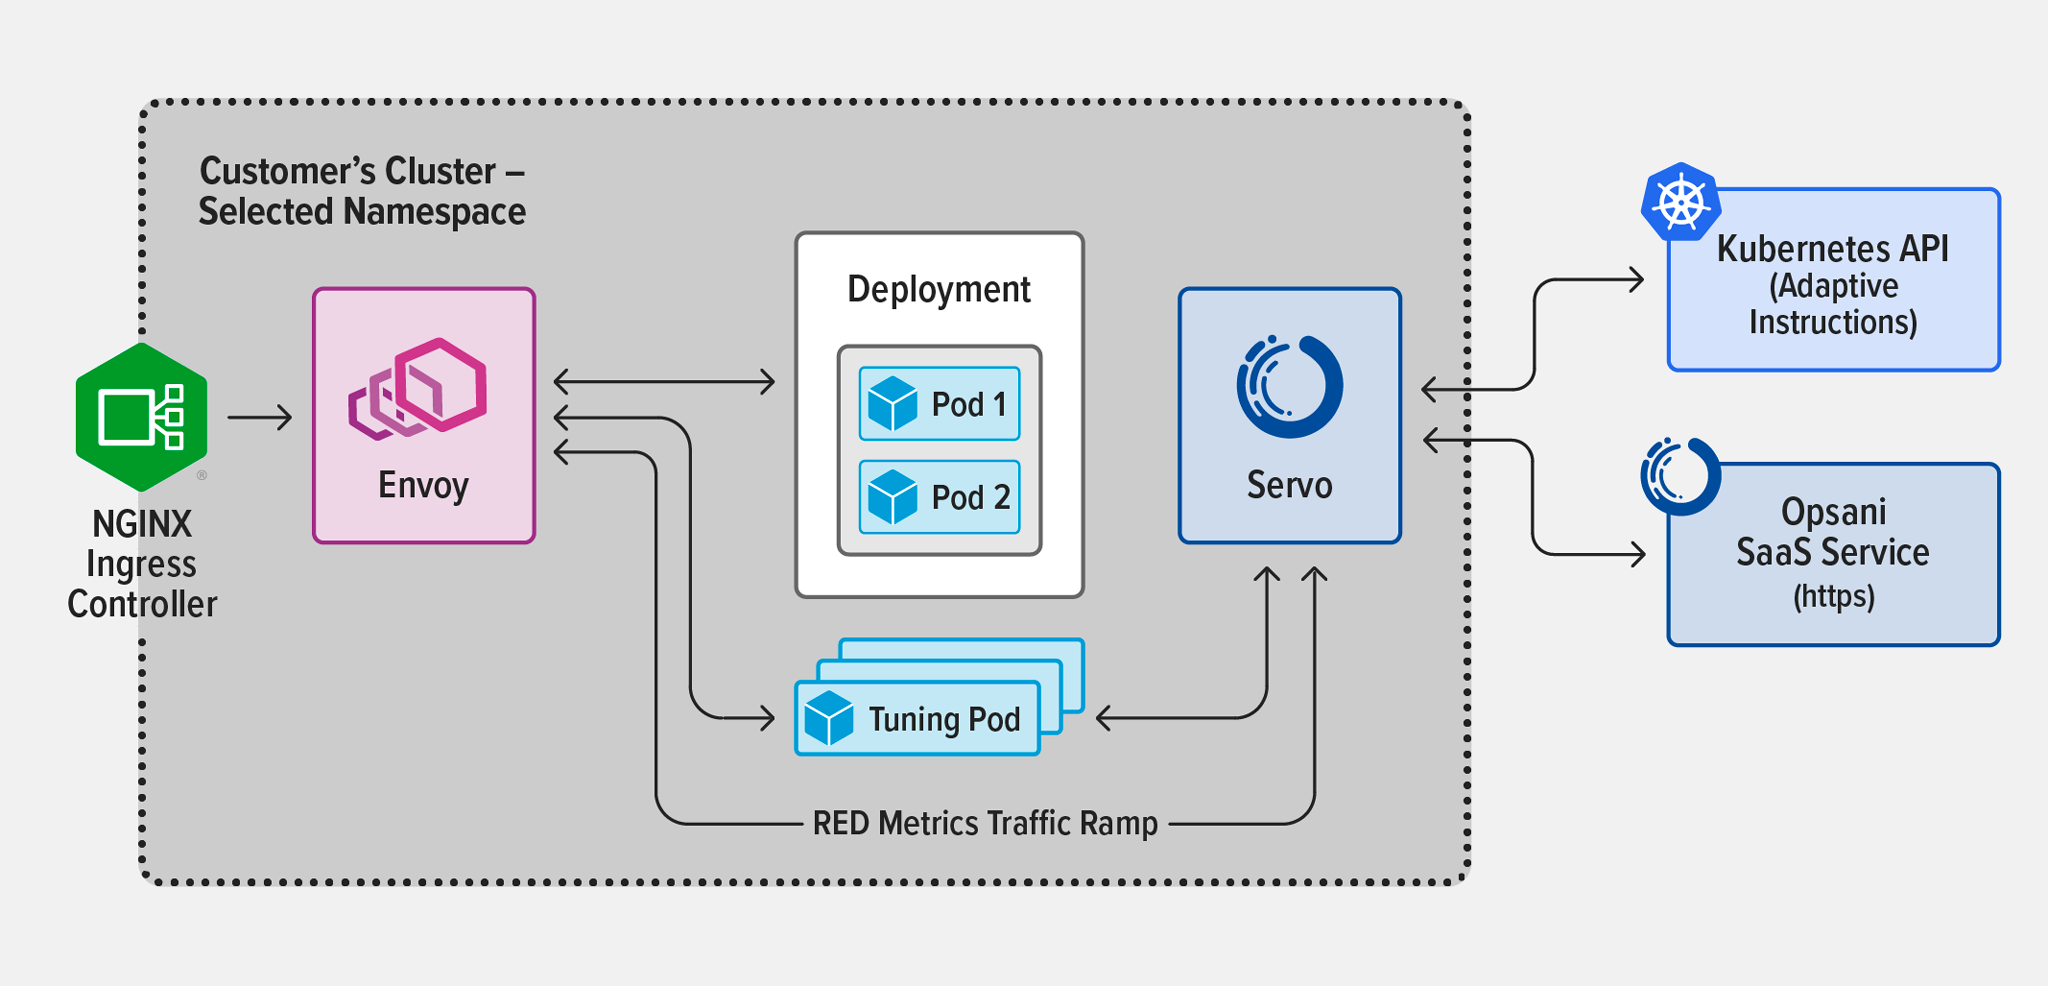
- 拓扑 2:基于NGINX Plus的NGINX Ingress Controller,使用Helm部署。指标采集采用与社区版Ingress Controller相同的Envoy部署和配置,以确保指标采集不会影响性能优化过程。
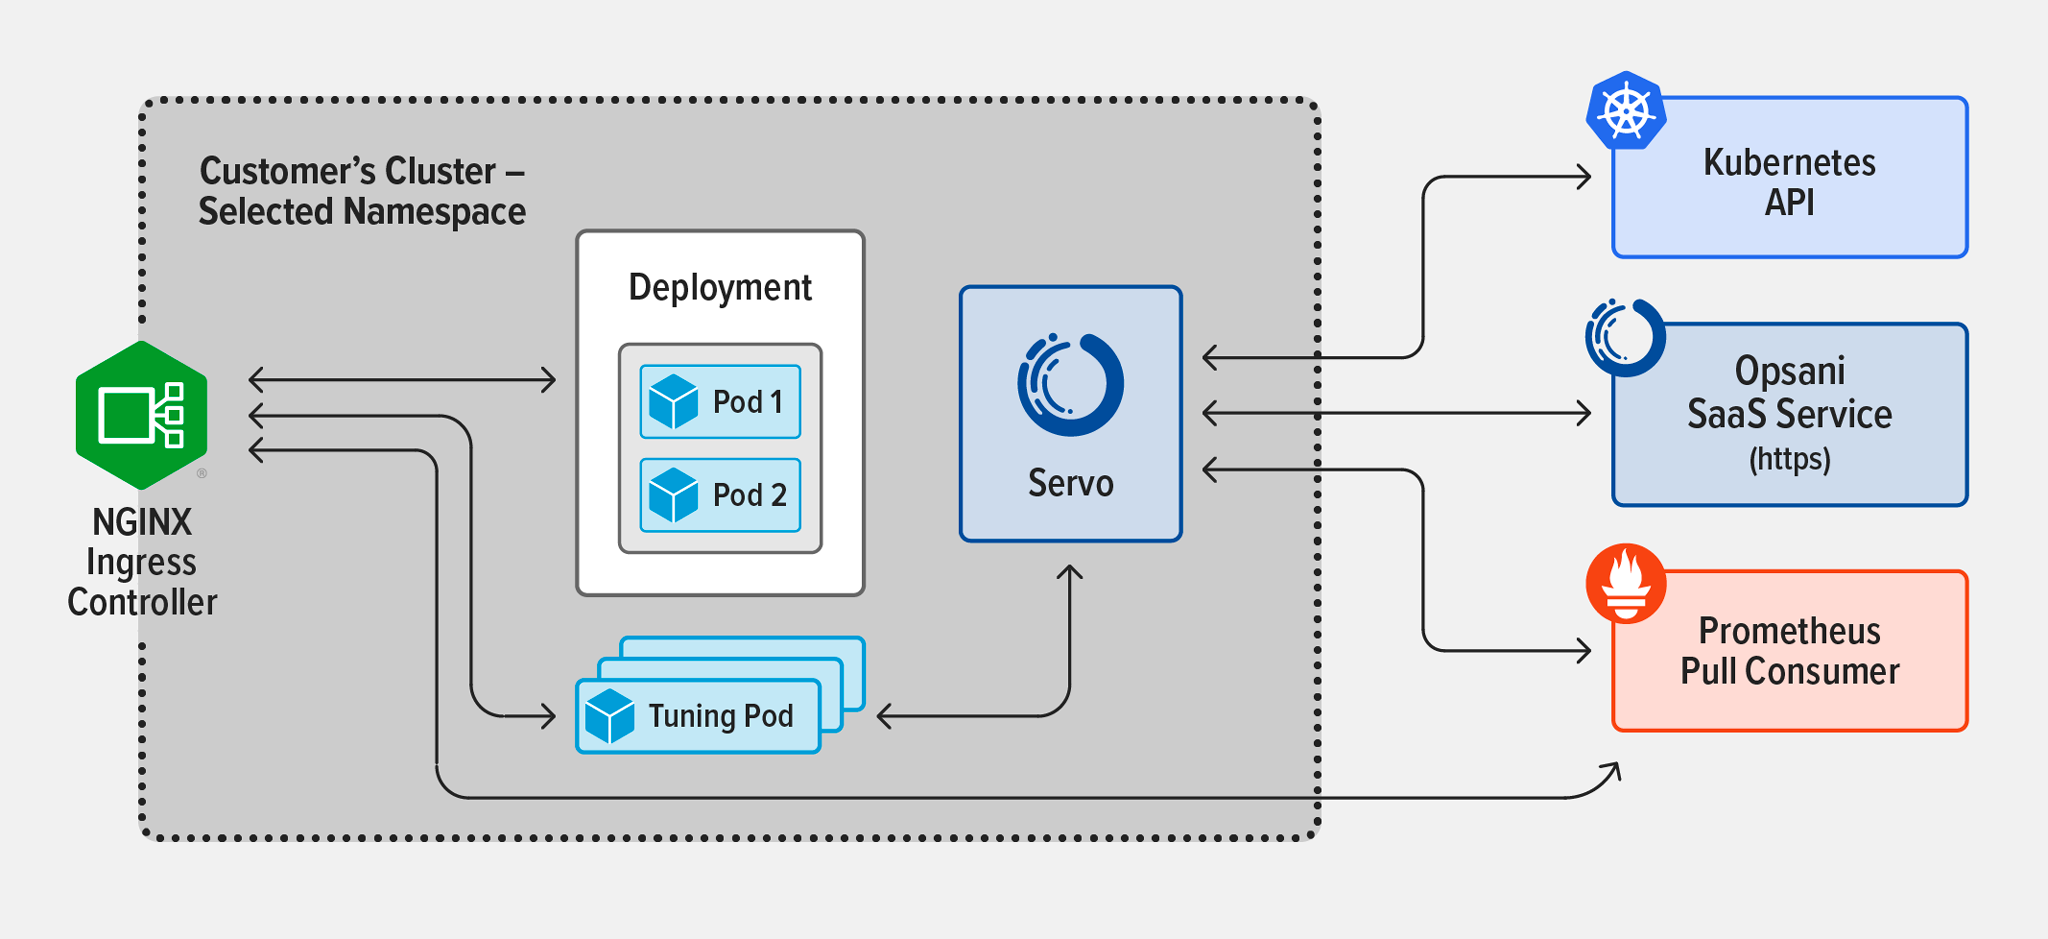
- 拓扑 3,基于NGINX Plus的NGINX Ingress Controller,同样使用Helm部署。指标通过Prometheus收集。
该表汇总了测试结果。可以看出,与社区版Ingress控制器相比,NGINX Ingress Controller在降低成本、优化CPU和内存方面表现更好。我们认为,这是因为NGINX Ingress Controller的负载均衡效率更高。
P50响应时间结果表明,Prometheus是更合适的指标收集方式,因为它省去了Envoy边车机制所需的额外一跳。对于社区版Ingress控制器,Envoy对P50响应时间没有影响;但对于NGINX Ingress Controller,Envoy实际上会使延迟增加4%。相比之下,Prometheus可将NGINX Ingress Controller的P50响应时间缩短5%。
| 拓扑 | 成本降低幅度(%) | P50响应时间(%) | CPU优化幅度(%) | 内存优化幅度(%) |
|---|---|---|---|---|
| 1 –采用Envoy的社区版Ingress控制器 | 44 | 0 | 44 | 44 |
| 2 – 采用Envoy的NGINX Ingress Controller | 70 | 4 | 63 | 81 |
| 3 – 采用Prometheus的Ingress控制器 | 70 | -5 | 63 | 81 |
有关测试执行方式的信息,请参阅附录。
Opsani如何优化NGINX Ingress Controller
即使应用在动态环境中的负载均衡效果不佳,Opsani也能对其进行优化。Opsani还可以利用任何类型的指标输入;但如果输入来自现有的网络指标收集工具,互联服务的优化效果会显著提升。为此,我们采用简单的部署流程,将Opsani与NGINX Ingress Controller集成。
在以NGINX作为Ingress控制器的环境中(目前许多应用都采用这种方式),只需改用基于NGINX Plus的NGINX Ingress Controller,即可获得更高效的负载均衡算法,同时不会对应用的其他功能产生影响。另一个优势是,还可以获取由NGINX Ingress Controller进行负载均衡的应用指标。
唯一的额外要求是,在优化命名空间下为应用部署一个Opsani Pod。适用于基于NGINX Plus的NGINX Ingress Controller的Opsani模板会将指标端点指向Ingress服务,以采集优化所需的应用专属指标。通过处理3至4个峰值时段的指标,Opsani引擎只需数小时即可达到较优的优化水平。截至目前,我们已将峰值负载优化了30%至70%。
开始使用Opsani和NGINX Ingress Controller
获取NGINX Ingress Controller和Opsani的免费试用版,然后前往我们的GitHub代码仓库,获取NGINX Ingress Controller和Opsani与Prometheus配合使用所需的脚本和配置文件。
附录:测试方法
先决条件
- 基于NGINX Plus的NGINX Ingress Controller以容器形式构建。
- Kubernetes已配置,并且注册表访问密钥可用于访问安全的私有Docker注册表。
- 基于NGINX Plus的NGINX Ingress Controller通过Helm部署到ingress命名空间。
- 已将NGINX VirtualServer资源配置为指向要优化的服务(默认通常为前端服务)。有关示例,请参阅GitHut代码库中的frontend-virtualserver.yaml。
拓扑和配置
我们创建了3个Opsani实例。对于拓扑1和2,我们使用所有Opsani账户均可用的标准Opsani Dev模板,并直接使用NGINX Ingress Controller作为应用的前端,将其指向应用服务。
对于拓扑 3,我们使用相同的默认模板,并通过 GitHub 仓库中 opsani-manifests-nginx-plus.yaml 所定义的 ConfigMap 修改 Servo 配置。与标准模板一样,我们会在 ConfigMap 中为以下变量替换为适当的值:
{{ NAMESPACE }},目标资源命名空间{{ DEPLOYMENT }}:目标部署{{ CONTAINER }}:目标应用容器名称
此外,我们根据应用部署时公开的文档设置OPSANI_ACCOUNT_NAME、OPSANI_APPLICATION_NAME和OPSANI_TOKEN。
虽然Opsani Dev的默认ServoX包含一个Prometheus实例,但我们改为将该Prometheus实例部署在与NGINX Ingress Controller相同的命名空间中,以减少配置ClusterRole的需要。
我们还配置了一项服务,使Servo Pod能够找到并查询正确的实例。此构件包含在opsani-manifests-nginx-plus.yaml中。
在Bank of Anthos作为示例Web应用运行且Ingress验证通过后,我们启动Ingress Prometheus实例。最后,可以通过应用opsani-manifests-nginx-plus.yaml文件来启动Opsani优化。
相关博客文章

NGINX Plus R26 正式发布
NGINX Plus R26通过缓存JSON Web密钥集加快JWT验证,并强化TLS握手,从而提升安全性。NGINX JavaScript的新功能包括增强对异步函数的支持,以及实现WebCrypto API。
使用NGINX App Protect DoS保护gRPC应用,抵御严重的DoS攻击
gRPC具备开发人员设计和部署现代应用所需的速度与灵活性,但其开放性也使其极易受到第7层DoS攻击。NGINX App Protect DoS可保护gRPC应用免受此类破坏性攻击。
Ingress Controller 选型指南(第 2 部分):风险与面向未来的规划
了解选择错误的Ingress控制器可能带来的风险,以及如何从关键方面着手,让您的选择更好地适应未来需求。
NGINX Plus R19 正式发布
NGINX Plus R19扩展了监控功能,不仅提供更多指标,还新增了指标分析方式;增加试运行模式,用于测试限速效果;增强键值存储,以支持IP地址范围;并使限速更加动态。
NGINX现已正式加入F5
NGINX现已正式成为F5的一部分。Gus Robertson现任F5 NGINX业务部门负责人。他阐述了两家公司在人才、文化和愿景方面融合的价值,以及双方将如何携手增强NGINX的开源产品和商业产品。
