去年秋季,我们在Sprint 2.0上推出NGINX现代应用参考架构(MARA)项目时,特别强调它不会像某些架构那样只是一个“玩具”,而是一个“可靠、经过测试,并可部署到Kubernetes环境中实际运行的生产应用”的解决方案。对于此类项目,可观测性工具必不可少。MARA团队的所有成员都亲身体会过,无法深入了解状态和性能会让应用开发和交付过程令人倍感挫折。因此,我们很快达成共识:MARA必须包含用于在生产环境中进行调试和跟踪的检测工具。
MARA的另一项指导原则是优先选择开源解决方案。本文将介绍我们如何在寻找多功能开源可观测性工具的过程中选定OpenTelemetry,并详细说明将OpenTelemetry与使用Python、Java和NGINX构建的微服务应用集成时所涉及的权衡、设计决策、方法和技术。
我们希望分享这些经验能帮助您避开潜在问题,加快采用OpenTelemetry。请注意,本文是一份具有时效性的进展报告;我们预计,文中讨论的技术将在一年内逐渐成熟。此外,尽管我们指出了部分项目目前存在的不足,但我们由衷感谢所有开源贡献,并期待看到这些项目不断发展。
我们的应用
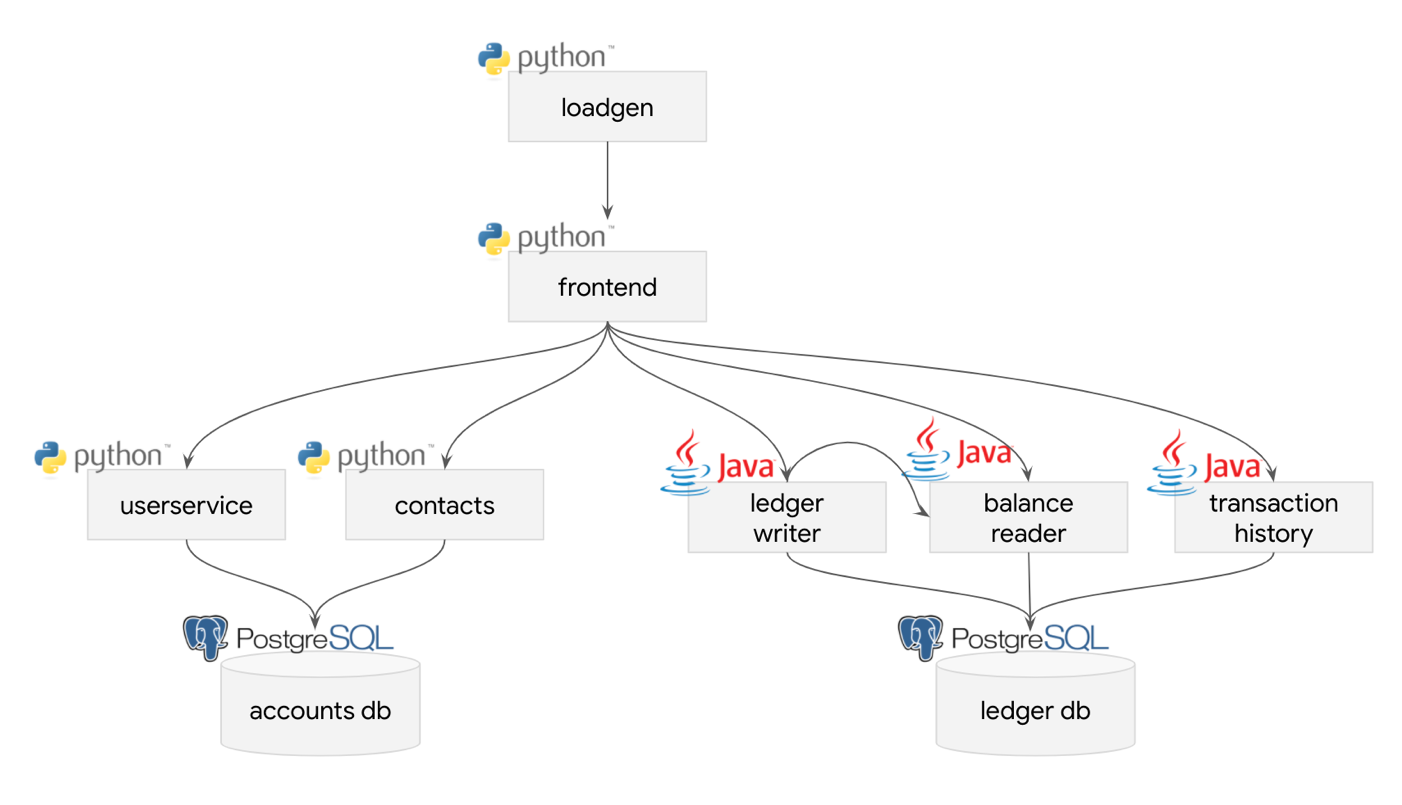
我们选择了Bank of Sirius作为与可观测性解决方案集成的应用。它是我们基于Google的Bank of Anthos示例应用创建的分支。这款采用微服务架构的Web应用可通过基础设施即代码进行部署。该应用在性能和可靠性方面仍有许多改进空间,但已足够成熟,可以合理地视为棕地应用。因此,我们认为它非常适合用于展示如何将OpenTelemetry集成到应用中,因为从理论上讲,分布式追踪可以深入揭示应用架构的不足。
如图所示,为该应用提供支持的服务相对简单。
我们为何选择OpenTelemetry
我们在选择OpenTelemetry的过程中经历了不少曲折,也经过了多个阶段。
创建功能愿望清单
在评估现有的开源可观测性工具之前,我们先确定了重点关注的可观测性方面。根据以往经验,我们整理出了以下列表。
- 日志记录,本文所称的日志记录,是指应用程序生成传统的、以换行符分隔的消息集合;Bank of Sirius应用采用Bunyan格式组织日志
- 分布式追踪:整个应用中每个组件的计时数据和元数据,类似于应用性能管理(APM)供应商提供的数据
- 指标:在一段时间内采集的测量值,并以时间序列数据的形式绘制成图
- 异常和错误聚合与通知:汇总最常见的异常和错误,并且必须支持搜索,以便确定哪些应用程序错误最常见
- 运行状况检查:定期向服务发送探测请求,以确定其在应用程序中是否正常运行
- 运行时状态内省:一组仅管理员可见的API,用于返回应用的运行时状态信息
- 堆转储/核心转储:服务运行时状态的全面快照;对我们而言,关键在于能否轻松地按需获取这些转储,或在服务崩溃时获取这些转储
对照愿望清单比较工具功能
当然,我们并不指望某一种开源工具或方法具备所有这些功能,但这份愿望清单至少为比较现有工具提供了一个理想的基准。我们查阅了各工具的文档,以确定它们支持愿望清单中七项功能里的哪些功能。下表汇总了我们的调查结果。
技术 日志记录 分布式追踪 指标 错误聚合 运行状况检查 运行时内省 堆转储/核心转储ELK + Elastic APM ✅ ✅ ✅ ✅ ✅ ❌ ❌Grafana ✅ ✅ ✅ ✅ ✅ ❌ ❌Graylog ✅ ❌ ❌ ❌ ❌ ❌ ❌Jaeger ❌ ✅ ❌ ✅ ❌ ❌ ❌OpenCensus ❌ ❌ ✅ ❌ ❌ ❌ ❌OpenTelemetry Beta ✅ ✅ ✅ ✅ * ❌ ❌Prometheus ❌ ❌ ✅ ❌ ❌ ❌ ❌StatsD ❌ ❌ ✅ ❌ ❌ ❌ ❌Zipkin ❌ ✅ ❌ ✅ ❌ ❌ ❌
*作为扩展
制作这张表时,我们才猛然意识到:这些工具在功能和用途上差异巨大,根本不能归为同一类别,就像拿苹果和烤面包机作比较一样!
例如,ELK(Elasticsearch-Logstash-Kibana,加上Filebeat)和Zipkin的用途存在根本差异,强行比较只会让人更加困惑。遗憾的是,“范围蔓延”让情况更加混乱。毫无疑问,为响应用户需求,这些工具增加了一些并非服务于其主要用途的次要功能,因而与其他工具的功能有所重叠。表面上看,ELK用于日志存储和可视化,而Zipkin用于分布式追踪。但只要稍微深入了解Elastic产品组合,很快就会发现Elastic APM。它支持分布式追踪,甚至还兼容Jaeger。
除了功能范围不断扩大的问题外,许多工具还可以相互集成,从而形成由收集器、聚合器、仪表板等组成的不同组合。其中一些技术相互兼容,另一些则不兼容。
开展定性调查
因此,这份对比表提供的信息不够准确,无法作为我们做出选择的依据。我们需要对每个项目的目标、指导原则和未来可能的发展方向进行定性研究。我们的判断是,项目的价值观与我们的价值观越相近,双方就越有可能长期保持兼容。访问各项目页面时,我们立即在OpenCensus页面上注意到了这一点。
OpenCensus和OpenTracing已合并为OpenTelemetry,后者是OpenCensus和OpenTracing的下一个主要版本。OpenTelemetry将向后兼容现有的OpenCensus集成,我们也将在未来两年内继续为现有OpenCensus库提供安全补丁。
对我们而言,这是一个关键的数据点。我们知道,无法保证所选方案能够适应未来的变化,但至少希望确认它今后会得到社区的有力支持。有了这些信息,我们就可以将OpenCensus从候选名单中排除。使用Jaeger可能也不是一个好主意,因为它是现已正式弃用的OpenTracing项目的参考实现,而大部分新贡献将会进入OpenTelemetry。
随后,我们深入了解了OpenTelemetry Collector。
OpenTelemetry Collector提供了一种与供应商无关的实现,用于接收、处理和导出遥测数据。此外,它无需运行、操作和维护多个代理或收集器,即可支持将开源遥测数据格式(例如Jaeger、Prometheus等)的数据发送到多个开源或商业后端。
OpenTelemetry Collector充当聚合器,可将不同的可观测性数据收集和插桩方法与不同的后端灵活组合。具体来说,应用程序可以使用Zipkin收集跟踪数据,并从Prometheus收集指标,然后将这些数据发送到可配置的后端,再通过Grafana进行可视化。此设计还支持多种其他组合,因此可以尝试不同的方法,确定哪些技术适合具体用例。
集成OpenTelemetry,迈向未来
总体而言,OpenTelemetry Collector吸引了我们,因为从理论上讲,它让我们能够在不同的可观测性技术之间切换。尽管该项目还不太成熟,我们仍决定大胆尝试,仅通过开源集成来使用OpenTelemetry,因为只有实际使用这些技术,才能了解整个技术格局。
不过,OpenTelemetry Collector仍缺少一些组件,因此我们必须依靠其他技术来实现相应功能。以下各节概述了我们的选择及其背后的原因。
实施日志记录
日志记录看似是可观测性中一个简单的环节,却很快会带来复杂的决策。简单之处在于,只需收集容器输出的日志;复杂之处在于,随后需要决定数据的存储位置、如何将数据传输到该存储位置、如何为数据建立索引以便使用,以及数据的保留期限。为发挥作用,日志文件需要支持按足够多的不同条件轻松搜索,以满足各类搜索人员的需求。
我们评估了OpenTelemetry Collector的日志记录支持;截至撰写本文时,该功能仍处于早期测试阶段。我们决定短期内使用ELK进行日志记录,同时继续研究其他方案。
在没有充分理由采用其他方案的情况下,我们默认使用Elasticsearch工具,从而可以将部署拆分为提取节点、协调节点、主节点和数据节点。为简化部署,我们使用了Bitnami chart。为传输数据,我们将Filebeat作为Kubernetes DaemonSet的一部分进行部署。我们还部署了Kibana,并利用预加载的索引、搜索、可视化和仪表板添加搜索功能。
很快我们就发现,虽然该解决方案可以正常运行,但默认配置会占用大量资源,因此很难在资源规模较小的环境中运行,例如K3S或Microk8s。通过增加调整各组件副本数量的功能解决了这一问题,但也确实出现了一些故障,可能是资源耗尽或数据量过大所致。
我们并未因此感到失望,而是将其视为一个机会,用于对采用不同配置的日志系统进行基准测试,并研究其他方案,例如Grafana Loki和Graylog。我们可能会发现,轻量级日志解决方案无法提供部分用户所需的全部功能,而资源占用较高的工具可以提供这些功能。鉴于MARA采用模块化设计,我们可能会为这些方案构建更多模块,为用户提供更多选择。
实施分布式追踪
除了确定哪种工具能够提供所需的追踪功能外,我们还需要考虑如何实施该解决方案,以及需要与哪些技术集成。
首先,我们希望确保任何插桩都不会对应用本身的服务质量产生负面影响。我们都曾使用过这样的系统:每小时导出日志时,性能都会如期下降。我们不想再经历这种情况。在这方面,OpenTelemetry Collector的架构很有吸引力,因为每台主机都可以运行一个实例。每个Collector都会接收主机上各个应用(无论是否容器化)中的客户端和代理所发送的数据。Collector会先聚合数据,并可能对其进行压缩,然后再发送到存储后端,这听起来很理想。
接下来,我们评估了应用所使用的不同编程语言和框架对OpenTelemetry的支持情况。这一环节稍显棘手。尽管只使用了表中所列的两种编程语言及相关框架,复杂程度却出乎意料地高。
语言 框架 服务数量Java Spring Boot 3Python Flask 3
为了添加语言级追踪,我们首先尝试了OpenTelemetry的自动插桩代理,但发现其输出杂乱且难以理解。随着自动插桩库日趋成熟,这种情况必将改善;但目前我们决定不使用OpenTelemetry代理,转而将追踪功能融入代码。
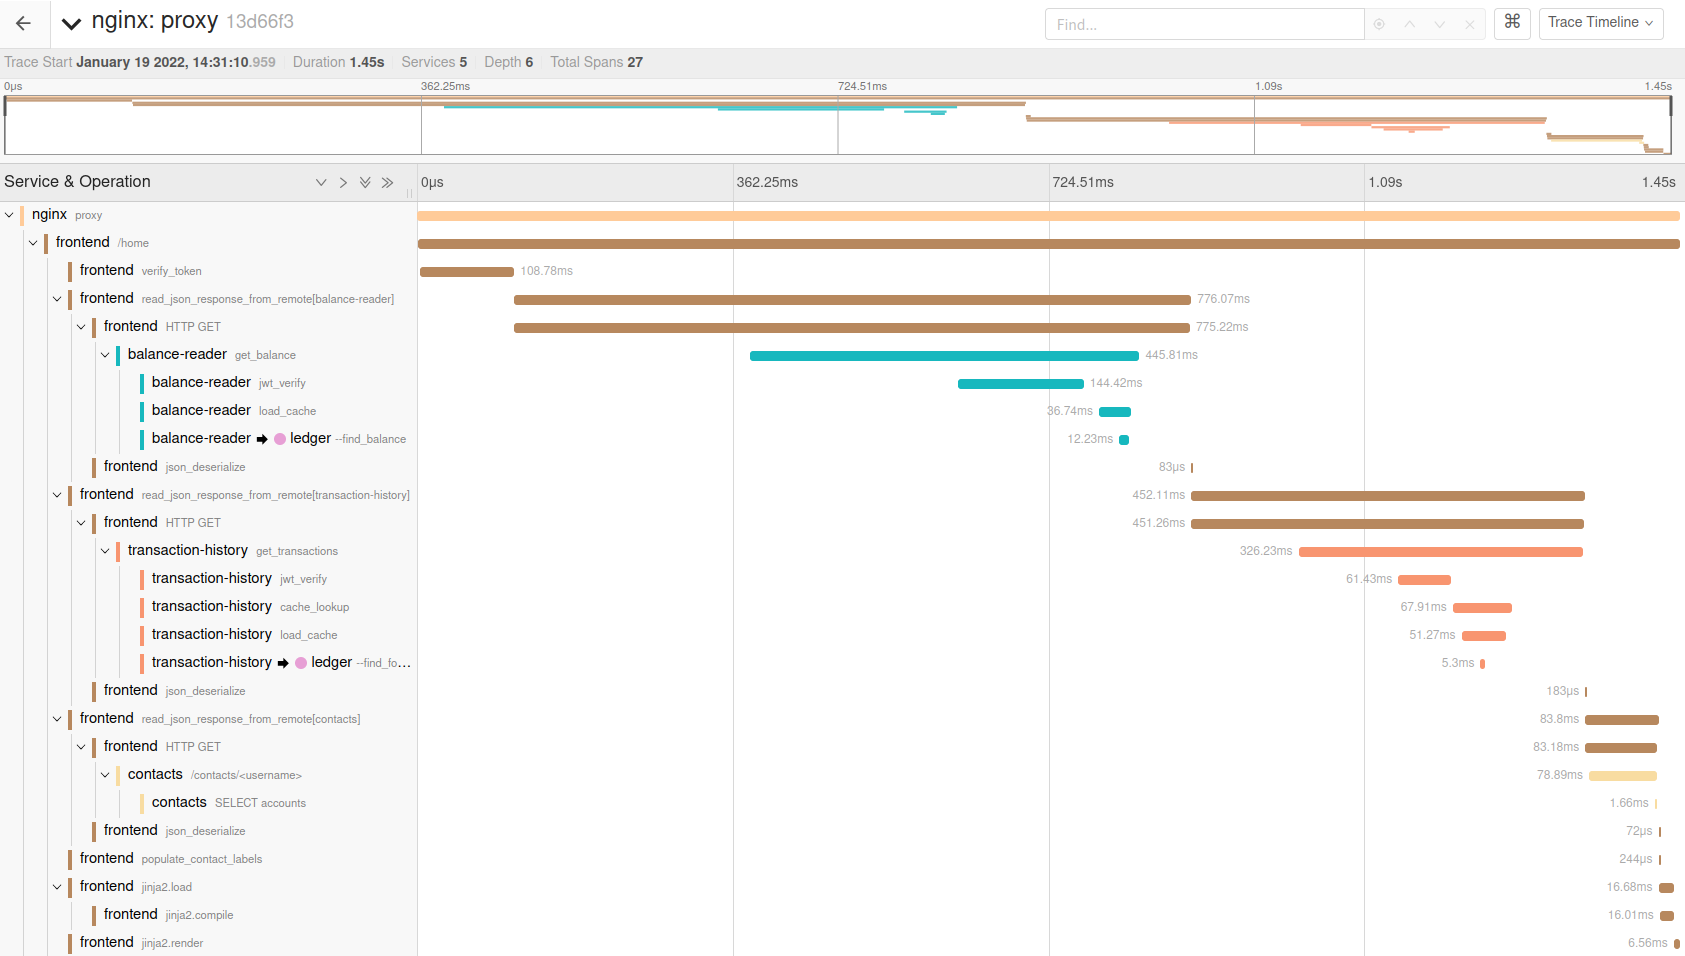
在着手直接在代码中实现追踪之前,我们先将OpenTelemetry Collector配置为把所有追踪数据输出到本地运行的Jaeger实例,以便更轻松地查看输出。这非常有用,因为在探索如何全面集成OpenTelemetry的过程中,我们可以尝试调整追踪数据的可视化呈现方式。例如,如果发现某个HTTP客户端库在调用依赖服务时未包含追踪数据,我们会立即将该问题列入修复清单。Jaeger可以清晰呈现单次追踪中的所有不同跨度:
Python分布式追踪
在Python代码中添加跟踪功能相对简单。我们添加了两个Python源文件,供所有服务引用,并更新了相应的requirements.txt文件,以纳入相关的opentelemetry-instrumentation-*依赖项。这样一来,所有Python服务都可以使用相同的跟踪配置,还可以在日志消息中包含每个请求的跟踪ID,并将跟踪ID嵌入发送给依赖服务的请求中。
Java分布式追踪
接下来,我们将重点转向Java服务。在全新项目中直接使用OpenTelemetry Java库相对简单,只需导入必要的库并直接使用跟踪API。但是,如果像我们一样使用Spring,还需要做出其他选择。
Spring已经提供了分布式追踪API,即Spring Cloud Sleuth。它在底层分布式追踪实现之上提供了一个外观接口,可实现文档中所述的以下功能:
- 将跟踪ID和跨度ID添加到Slf4J MDC,以便在日志聚合器中提取指定跟踪或跨度的所有日志。
- 对Spring应用程序的常见入口点和出口点进行插桩(servlet过滤器、RestTemplate、计划任务、消息通道、Feign客户端)。
- 如果
spring-cloud-sleuth-zipkin可用,则会通过HTTP生成并报告与Zipkin兼容的跟踪数据。默认情况下,这些数据会发送到localhost上的Zipkin收集器服务(端口9411)。请使用spring.zipkin.baseUrl配置该服务的位置。
该API还支持为带有@Scheduled注解的任务添加跟踪。
换言之,只需使用Spring Cloud Sleuth,即可开箱即用地获得HTTP服务端点级别的跟踪,这是一项很实用的优势。由于项目已经使用Spring,我们决定将所有组件都保留在该框架内,并利用其提供的功能。不过,在使用Maven整合所有组件时,我们发现了一些问题:
- The Spring Cloud Sleuth Autoconfigure module仍处于里程碑版本阶段。
- Spring Cloud Sleuth Autoconfigure模块依赖于过时的alpha版本
opentelemetry-instrumentation-api。此库目前没有较新的非alpha 1.x版本。 - 由于Spring Cloud Sleuth对里程碑版本的依赖项引用采用特定编码方式,项目必须从Spring Snapshot存储库中拉取父项目对象模型(POM)
spring-cloud-build。
这使我们的Maven项目定义变得稍微复杂了一些,因为我们必须让Maven同时从Spring存储库和Maven Central拉取资源,这清楚地表明当时Spring Cloud对OpenTelemetry的支持尚处于早期阶段。尽管如此,我们仍继续推进,并创建了一个通用遥测模块,用于通过Spring Cloud Sleuth和OpenTelemetry配置分布式追踪,其中包含各种与遥测相关的辅助函数和扩展。
在通用遥测模块中,我们通过提供以下功能,扩展了Spring Cloud Sleuth和OpenTelemetry库所提供的追踪功能:
- 支持Spring的
Autoconfiguration类,用于为项目设置跟踪和扩展功能,并加载其他跟踪资源属性。 - NoOp接口实现,因此可以在启动时通过向所有Spring Cloud Sleuth接口注入NoOp实例来禁用追踪。
- 用于规范化跟踪名称的跟踪命名拦截器。
- 一个错误处理程序,通过slf4j和Spring Cloud Sleuth跟踪功能输出错误。
- 一种增强实现,用于扩展跟踪属性,将更多信息编码到发出的每条跟踪记录中,包括服务版本、服务实例ID、机器ID、Pod名称、容器ID、容器名称和命名空间名称。
- 一个跟踪语句检查器,用于将跟踪ID注入Hibernate所发出SQL语句之前的注释中。现在似乎可以使用SQLCommenter实现此功能,但我们尚未迁移到该工具。
此外,我们还实现了一个与Spring兼容的HTTP客户端。该客户端基于Apache HTTP Client构建,旨在为服务间的HTTP调用提供更多指标和更强的可定制性。在此实现中,调用依赖服务时,跟踪标识符和跨度标识符会通过标头传递,以便将其纳入跟踪输出。此外,此实现还提供由OpenTelemetry聚合的HTTP连接池指标。
总而言之,将 Spring Cloud Sleuth 和 OpenTelemetry 接入链路追踪的过程十分艰难,但我们认为这一切都是值得的。希望这个项目和这篇文章能为其他希望采用这一方案的人提供指引。
NGINX分布式追踪
为了获取贯穿请求整个生命周期并连接所有服务的跟踪数据,我们需要将OpenTelemetry集成到NGINX中。为此,我们使用了OpenTelemetry NGINX模块(仍处于测试阶段)。考虑到可能难以获得适用于所有NGINX版本的该模块可用二进制文件,我们创建了一个GitHub存储库,其中包含集成了不受支持的NGINX模块的容器镜像。我们每晚执行构建,并通过易于导入的Docker镜像分发该模块的二进制文件。
我们尚未将此流程集成到构建流程中,该流程用于NGINX Ingress Controller在MARA项目中的构建,但计划很快完成这项工作。
实施指标收集
完成OpenTelemetry的跟踪集成后,我们将重点转向指标。基于Python的应用尚无现成指标,因此我们决定暂缓添加。对于Java应用,原始Bank of Anthos源代码使用Micrometer并结合Google Cloud的Stackdriver来支持指标。不过,从Bank of Anthos派生出Bank of Sirius后,我们移除了这部分代码,因为它不支持配置指标后端。尽管如此,已有的指标钩子表明,仍需进行适当的指标集成。
为了找到一种可配置且实用的解决方案,我们首先研究了OpenTelemetry Java库和Micrometer对指标的支持。通过搜索这两种技术的对比,我们发现多项结果列举了OpenTelemetry的不足。尽管在撰写本文时,OpenTelemetry指标功能仍处于Alpha阶段,但这些结果指出了将OpenTelemetry用作JVM指标API时的不足。Micrometer是一个成熟的JVM指标门面层,类似于slf4j,它提供通用API封装,前接可配置的指标实现,而非自身实现指标功能。值得注意的是,它是Spring的默认指标API。
此时,我们正在权衡以下事实:
- OpenTelemetry Collector几乎可以使用来自任何来源的指标,包括Prometheus、StatsD以及原生的OpenTelemetry Protocol(OTLP)
- Micrometer还支持大量指标后端,包括Prometheus和StatsD
- 适用于JVM的OpenTelemetry Metrics SDK支持通过OTLP发送指标
经过几次实验,我们认为最务实的方法是使用Micrometer门面和Prometheus后端实现,并将OpenTelemetry Collector配置为通过Prometheus API从应用程序中拉取指标。我们从许多文章中了解到,OpenTelemetry缺少某些指标类型可能会导致问题,但我们的用例不需要这些类型,因此可以接受这种折中方案。
我们发现了OpenTelemetry Collector一个有趣的特性:虽然已将其配置为通过OTLP接收跟踪数据,并通过Prometheus API接收指标,但仍可将其配置为使用OTLP或任何其他受支持的协议,将这两类数据发送到外部数据接收器。因此,我们可以轻松地使用LightStep试用应用程序。
总体而言,在Java中编写指标代码相当简单,因为我们按照Micrometer API的规范进行编写,并且有大量示例和教程可供参考。对于指标和追踪而言,最困难的可能是正确配置pom.xml文件中telemetry-common的Maven依赖关系图。
实现错误聚合
严格来说,OpenTelemetry项目的使命并不包括错误聚合,其错误标记实现也不如Sentry或Honeybadger.io等解决方案简洁易用。尽管如此,我们决定短期内使用OpenTelemetry进行错误聚合,而不是再添加一种工具。借助Jaeger等工具,我们可以搜索error=true,找出所有存在错误状况的跟踪记录。这样至少可以帮助我们了解常见问题。未来,我们可能会考虑添加Sentry集成。
实施健康检查和运行时内省
在我们的应用中,健康检查可让 Kubernetes 了解服务是否处于健康状态,或是否已完成启动阶段。如果服务运行状况不佳,可以将 Kubernetes 配置为终止或重启实例。由于我们发现相关文档不够完善,因此决定不在应用中使用 OpenTelemetry 健康检查。
对于JVM服务,我们改用一个名为Spring Boot Actuator的Spring项目。它不仅提供健康检查端点,还提供运行时内省和堆转储端点。对于Python服务,我们使用Flask Management Endpoints module,它提供Spring Boot Actuator的部分功能。目前,它仅提供可自定义的应用信息和健康检查。
Spring Boot Actuator 与 JVM 和 Spring 集成,提供内省、监控和运行状况检查端点。此外,它还提供了一个框架,可在端点呈现的默认数据中添加自定义信息。这些端点可对缓存状态、运行时环境、数据库迁移、运行状况检查、可自定义的应用程序信息、指标、周期性作业、HTTP 会话状态和线程转储等内容进行运行时内省。
Spring Boot Actuator实现的运行状况检查端点采用模块化配置,因此服务的运行状况可由多个单独检查组成,这些检查分为存活检查和就绪检查。此外,还提供可显示所有检查模块的完整运行状况检查,通常如下所示:此示例。
信息端点在JSON文档中定义,由一个顶层JSON对象以及一系列分层的键和值组成。该文档通常会指定服务名称和版本、体系结构、主机名、操作系统信息、进程ID、可执行文件名称,以及计算机ID或唯一服务ID等主机详细信息。
实现堆转储和核心转储
您可能还记得,“工具功能与愿望清单对比”中的表格显示,这些工具均不支持运行时内省或堆转储和核心转储。不过,作为底层框架的Spring同时支持这两项功能,只是需要进行一些配置,才能将可观测性功能集成到应用程序中。如上一节所述,我们结合使用Python模块和Spring Boot Actuator来实现运行时内省。
同样,对于堆转储,我们使用Spring Boot Actuator提供的线程转储端点来实现部分所需功能。我们无法按需获取核心转储,也无法以理想的精细粒度获取JVM堆转储,但只需投入少量额外工作,就能实现部分所需功能。遗憾的是,要为Python服务实现核心转储,还需要投入大量额外工作,因此我们已将其推迟到以后再处理。
总结
经过一番痛苦挣扎和自我怀疑,我们最终决定在MARA中使用以下技术实现可观测性(下文中,OTel指OpenTelemetry):
- 日志记录(适用于所有容器):Filebeat → Elasticsearch / Kibana
- 分布式追踪
- Java:Spring Cloud Sleuth → Spring Cloud Sleuth exporter for OTel → OTel Collector → Jaeger、Lightstep、Splunk等可插拔导出器
- Python:OTel Python库 → OTel Collector → 可插拔存储
- NGINX和NGINX Plus(尚不支持NGINX Ingress Controller),NGINX OTel模块 → OTel Collector → 可插拔导出器
- 指标收集
- Java:通过Spring使用Micrometer → Prometheus导出器 → OTel Collector
- Python:尚未实现
- Python WSGI,GUnicorn StatsD → Prometheus(通过StatsD或ServiceMonitor)
- NGINX,Prometheus端点 → Prometheus(通过ServiceMonitor)
- 错误聚合:OTel分布式跟踪 → 可插拔导出器 → 使用导出器的搜索功能查找标记为
error - 运行状况检查
- Java:Spring Boot Actuator → Kubernetes
- Python:Flask Management Endpoints模块 → Kubernetes
- 运行时内省
- Java:Spring Boot Actuator
- Python:Flask Management Endpoints模块
- 堆转储和核心转储
- Java:Spring Boot Actuator支持线程转储
- Python,暂不支持
此实现仅反映当前状态。随着开发工作的持续推进,它必将不断变化和演进。我们很快将对该应用进行大规模负载测试。我们预计将从中深入了解当前可观测性方法的不足,并添加更多可观测性功能。
欢迎试用Modern Apps Reference Architecture和示例应用(Bank of Sirius)。如果您对如何进一步改进有任何想法,欢迎在我们的GitHub代码仓库中贡献力量!
相关文章
本文是系列文章的一部分。随着我们逐步为MARA添加新功能,我们会在博客中发布详细信息:
- 全新的开源现代应用参考架构
- 将OpenTelemetry集成到现代应用参考架构中:进展报告(本文)
- MARA:现已可在您身边的工作站上运行
- NGINX Modern Apps Reference Architecture 1.0.0版正式发布
相关博客文章

NGINX Plus R26 正式发布
NGINX Plus R26通过缓存JSON Web密钥集加快JWT验证,并强化TLS握手,从而提升安全性。NGINX JavaScript的新功能包括增强对异步函数的支持,以及实现WebCrypto API。
使用NGINX App Protect DoS保护gRPC应用,抵御严重的DoS攻击
gRPC具备开发人员设计和部署现代应用所需的速度与灵活性,但其开放性也使其极易受到第7层DoS攻击。NGINX App Protect DoS可保护gRPC应用免受此类破坏性攻击。
Ingress Controller 选型指南(第 2 部分):风险与面向未来的规划
了解选择错误的Ingress控制器可能带来的风险,以及如何从关键方面着手,让您的选择更好地适应未来需求。
NGINX Plus R19 正式发布
NGINX Plus R19扩展了监控功能,不仅提供更多指标,还新增了指标分析方式;增加试运行模式,用于测试限速效果;增强键值存储,以支持IP地址范围;并使限速更加动态。
NGINX现已正式加入F5
NGINX现已正式成为F5的一部分。Gus Robertson现任F5 NGINX业务部门负责人。他阐述了两家公司在人才、文化和愿景方面融合的价值,以及双方将如何携手增强NGINX的开源产品和商业产品。
