编者:本系列共7篇文章,现已全部发布:
- 微服务简介
- 构建微服务:使用API网关
- 构建微服务:微服务架构中的进程间通信
- 微服务架构中的服务发现
- 微服务的事件驱动型数据管理(本文)
- 选择微服务部署策略
- 将单体应用重构为微服务
还可以下载电子书,其中收录了全套文章以及使用NGINX Plus实施微服务的相关信息:《微服务:从设计到部署》。另请参阅微服务参考架构系列文章和微服务解决方案页面。
本文是微服务应用构建系列的第5篇文章。第1篇文章介绍了微服务架构模式,并探讨了使用微服务的优缺点。第2篇<.htmla>和第3篇文章介绍了微服务架构中通信的不同方面。第4篇文章探讨了与之密切相关的服务发现问题。本文将转而介绍微服务架构中出现的分布式数据管理问题。
微服务与分布式数据管理问题
单体应用通常使用单个关系数据库。使用关系数据库的一项主要优势是,应用可以使用ACID事务,从而获得一些重要保障:
- 原子性:更改以原子方式完成
- 一致性:数据库的状态始终保持一致
- 隔离性:即使事务并发执行,其效果也如同串行执行
- 持久性:事务一旦提交,就不会撤销
因此,应用程序只需启动一个事务,更改多行数据(插入、更新和删除),然后提交该事务。
使用关系数据库的另一项重要优势是,它提供了SQL这一功能丰富、声明式且标准化的查询语言。您可以轻松编写查询,整合多个表中的数据。随后,RDBMS查询规划器会确定适当的查询执行方式。无需考虑如何访问数据库等底层细节。此外,由于应用程序的所有数据都存储在同一个数据库中,因此查询起来很方便。
遗憾的是,迁移到微服务架构后,数据访问会变得复杂得多。这是因为每个微服务拥有的数据仅供该微服务使用,只能通过其API访问。封装数据可确保微服务保持松耦合,并能彼此独立演进。如果多个服务访问同一数据,更新架构时就需要协调更新所有服务,十分耗时。
更棘手的是,不同的微服务往往使用不同类型的数据库。现代应用需要存储和处理多种类型的数据,而关系型数据库并非始终是合适的选择。对于某些用例,特定的NoSQL数据库可能具有更便捷的数据模型,并能提供更出色的性能和可扩展性。例如,存储和查询文本的服务适合使用Elasticsearch等文本搜索引擎。同样,存储社交图谱数据的服务通常更适合使用Neo4j等图数据库。因此,基于微服务的应用往往会混合使用SQL和NoSQL数据库,这种方法称为“多语言持久化”。
采用分区和多语言持久化的数据存储架构具有诸多优势,包括实现服务松耦合,以及提升性能和可扩展性。不过,这种架构也确实会带来一些分布式数据管理方面的挑战。
第一个挑战是如何实现可在多个服务之间保持一致性的业务事务。为了说明这一问题,我们来看一个在线B2B商店的示例。客户服务负责维护客户信息,包括客户的信用额度。订单服务负责管理订单,并且必须验证新订单是否超出客户的信用额度。在此应用的单体版本中,订单服务只需使用ACID事务检查可用信用额度并创建订单。
相比之下,在微服务架构中,ORDER表和CUSTOMER表分别由各自的服务专用,如下图所示。
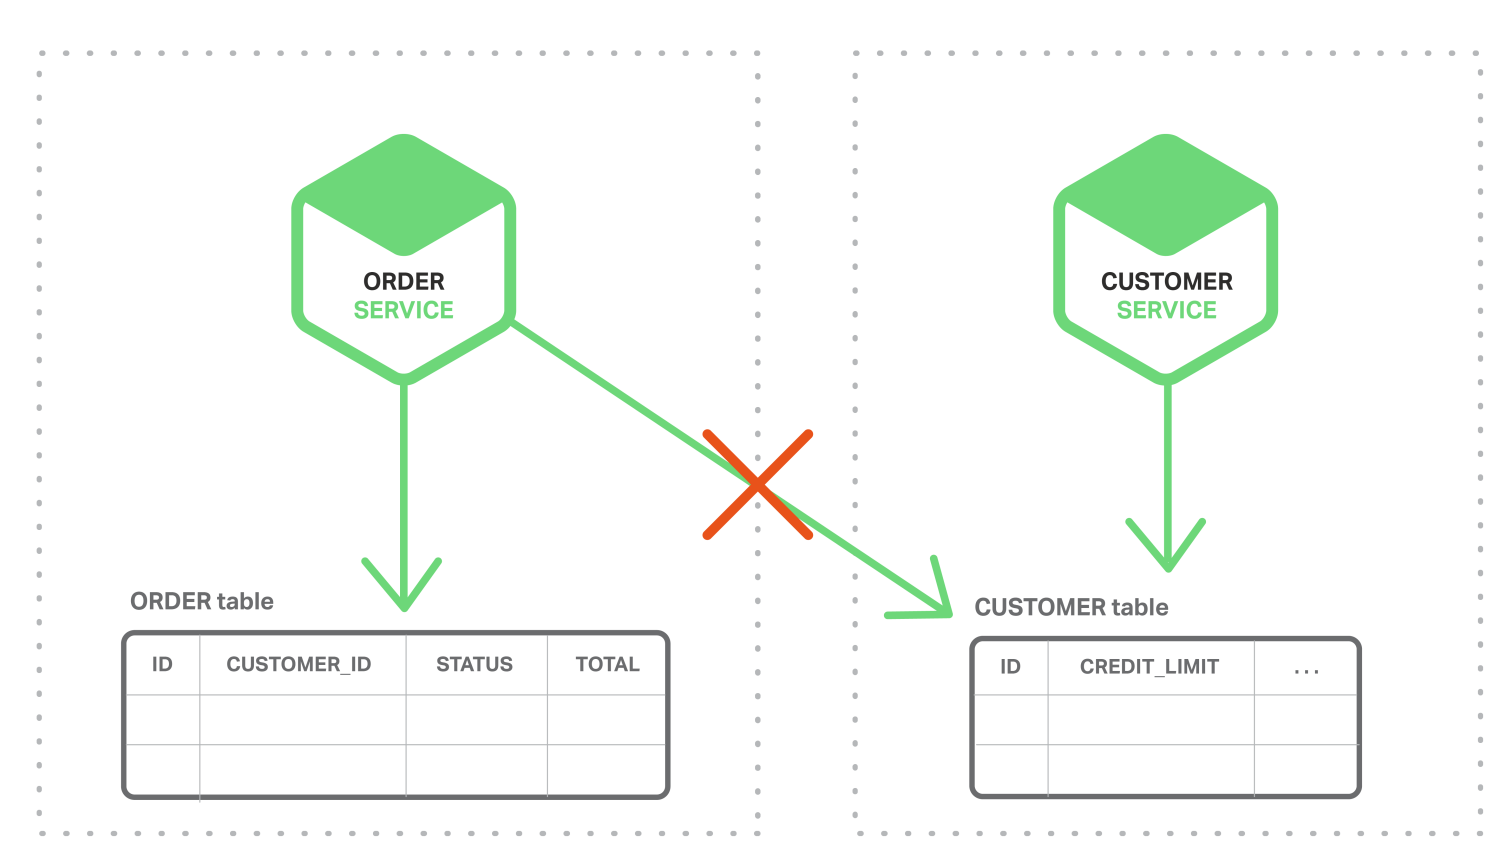
订单服务无法直接访问CUSTOMER表,只能使用客户服务提供的API。订单服务可以考虑使用分布式事务,也称为两阶段提交(2PC)。但在现代应用中,2PC通常并不可行。CAP定理要求在可用性与ACID式一致性之间做出选择,而可用性通常是更合适的选择。此外,许多现代技术(例如大多数NoSQL数据库)并不支持2PC。必须确保跨服务和数据库的数据一致性,因此需要采用其他解决方案。
第二个挑战是如何实现从多个服务检索数据的查询。例如,假设应用需要显示某位客户及其近期订单。如果订单服务提供用于检索客户订单的API,则可以使用应用端联接来检索这些数据。应用从客户服务检索客户信息,并从订单服务检索该客户的订单。但假设订单服务仅支持按主键查找订单(可能是因为它使用的NoSQL数据库仅支持基于主键的检索)。在这种情况下,没有显而易见的方法可以检索所需数据。
事件驱动架构
对于许多应用,解决方案是采用事件驱动架构。在这种架构中,当发生值得关注的情况(例如更新业务实体)时,微服务会发布事件。其他微服务会订阅这些事件。微服务收到事件后,可以更新自己的业务实体,这可能会触发更多事件的发布。
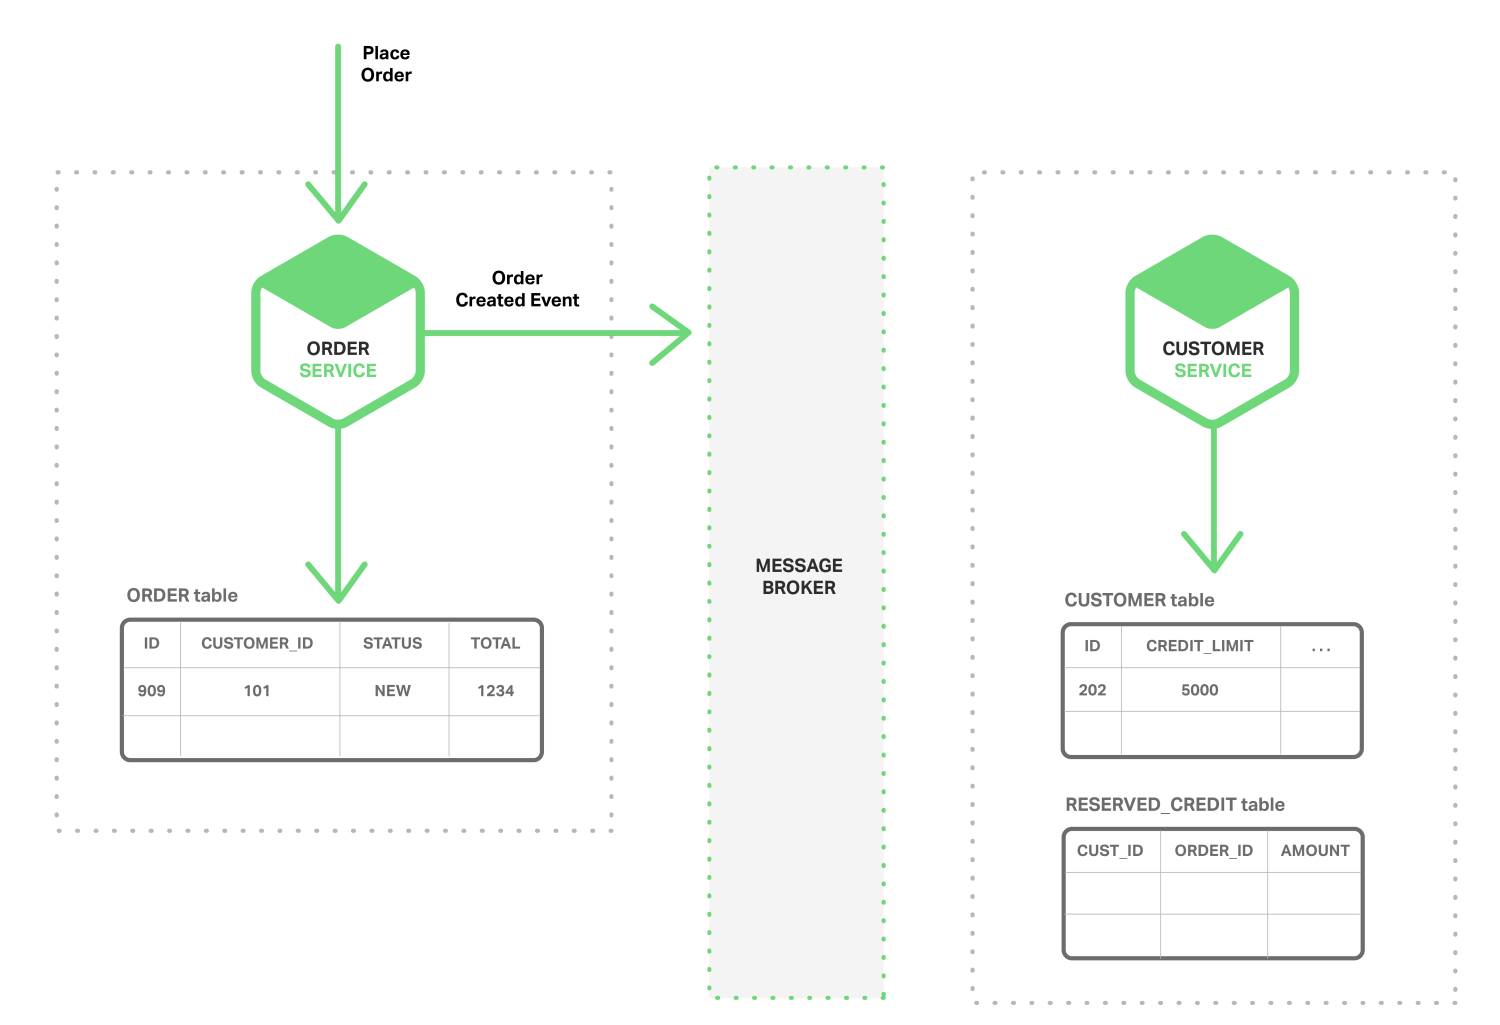
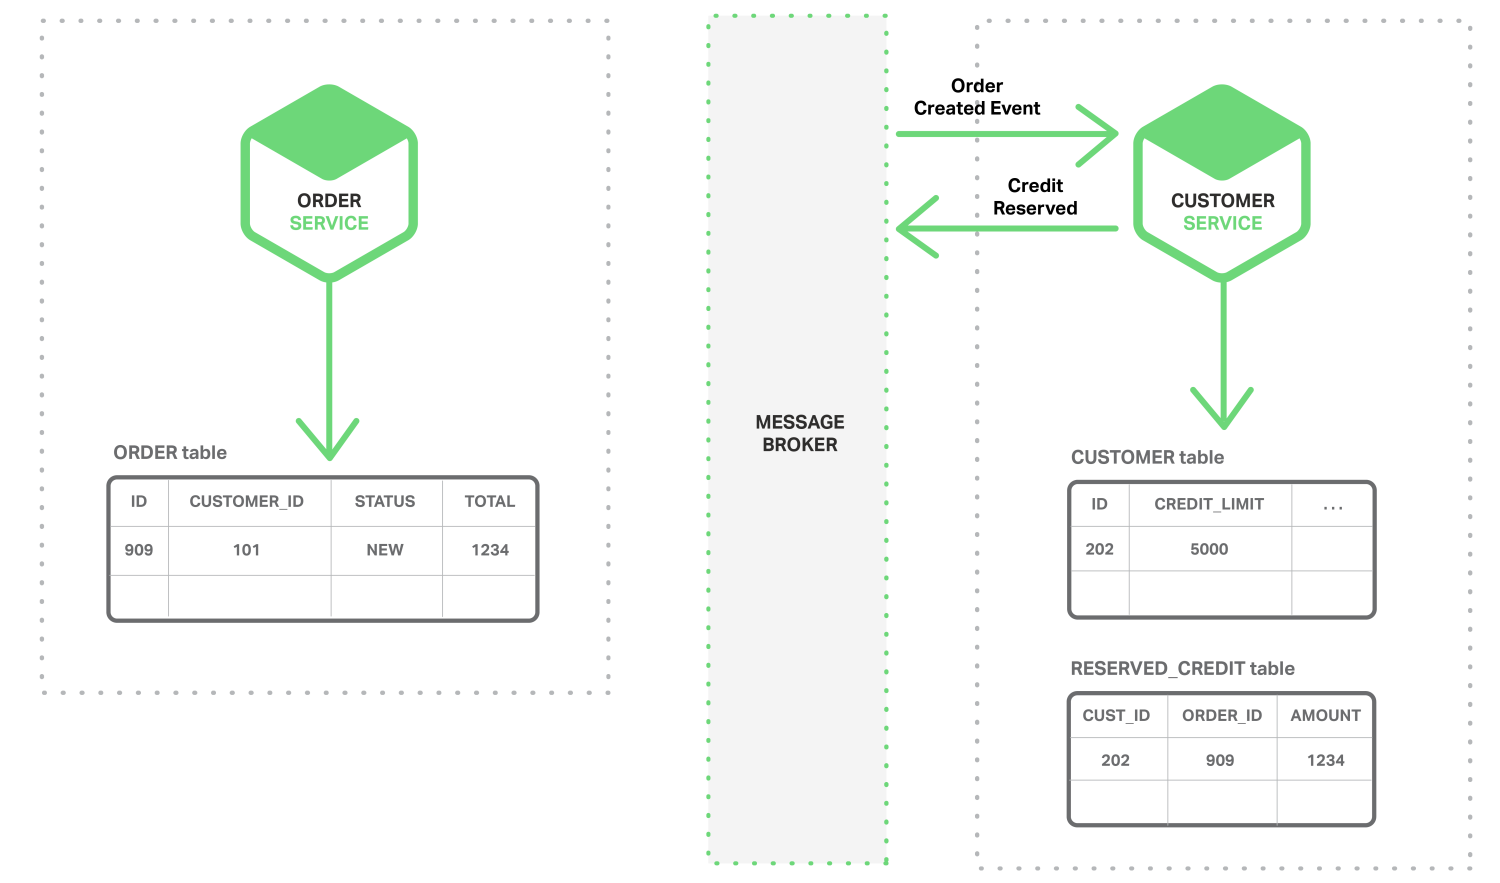
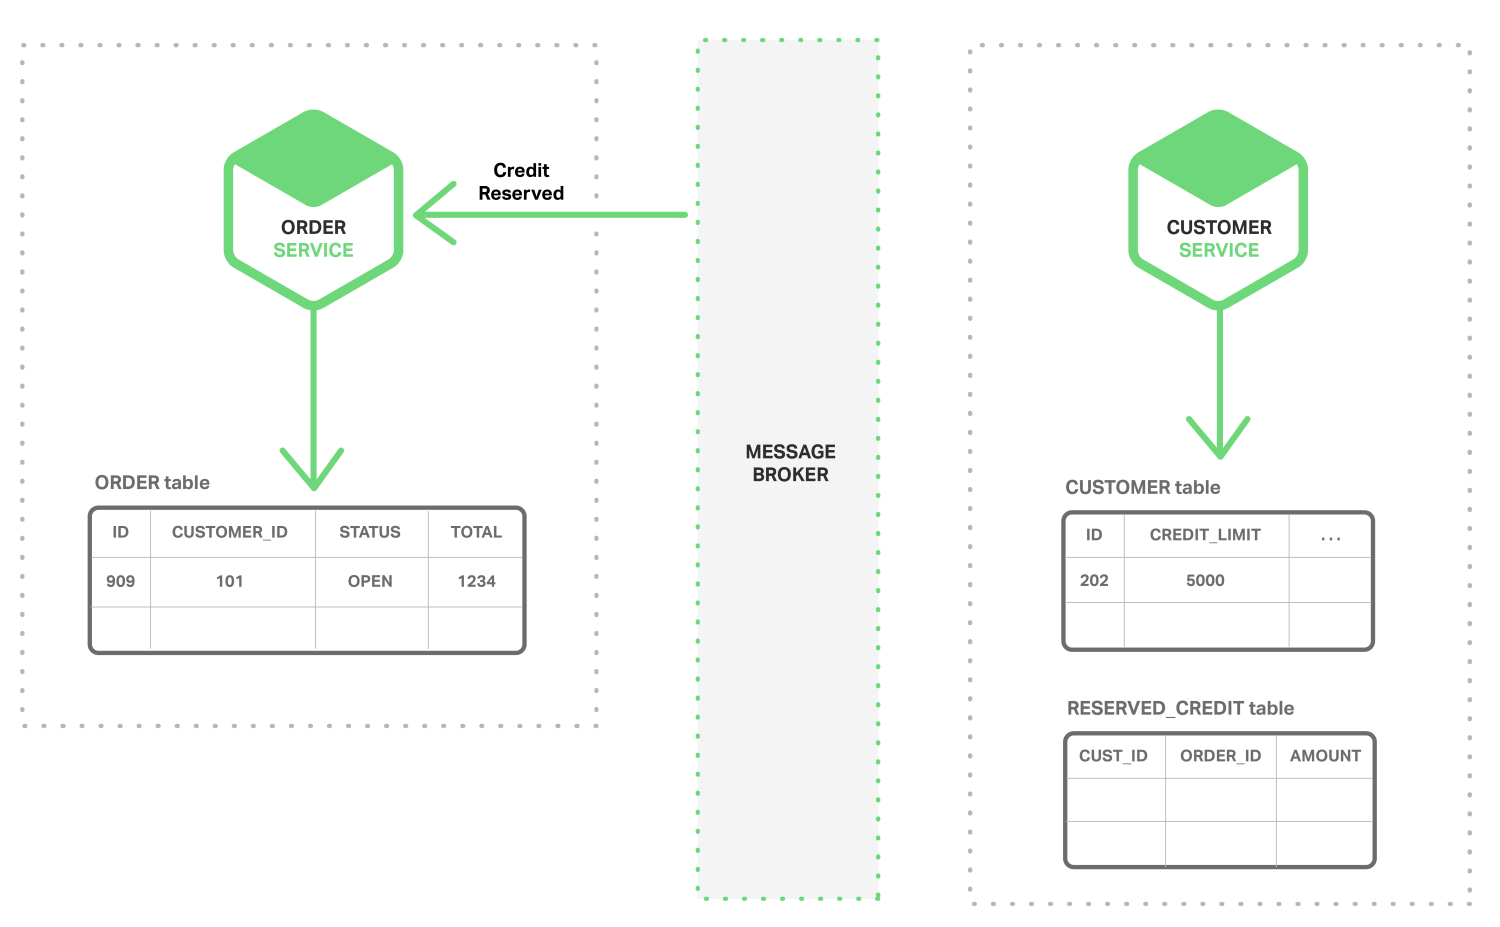
可以使用事件来实现跨多个服务的业务事务。一个事务由一系列步骤组成。在每个步骤中,微服务会更新一个业务实体,并发布一个事件来触发下一步。以下一系列图示说明了如何在创建订单时使用事件驱动方法检查可用信用额度。微服务通过消息代理交换事件。
- 订单服务创建状态为NEW的订单,并发布“订单已创建”事件。
- 客户服务使用“订单已创建”事件,为该订单预留信用额度,并发布“信用额度已预留”事件。
- 订单服务使用“Credit Reserved”事件,并将订单状态更改为 OPEN。
更复杂的场景可能还包括其他步骤,例如在检查客户信用的同时预留库存。
如果满足以下条件:(a)每个服务以原子方式更新数据库并发布事件(稍后将详细介绍);(b)消息代理保证事件至少交付一次,那么就可以实现跨多个服务的业务事务。需要注意的是,这些事务并非ACID事务,其保证要弱得多,例如最终一致性。这种事务模型称为BASE模型。
还可以使用事件来维护物化视图,预先联接多个微服务所拥有的数据。负责维护视图的服务会订阅相关事件并更新视图。例如,负责维护“客户订单”视图的“客户订单视图更新器服务”会订阅“客户服务”和“订单服务”发布的事件。
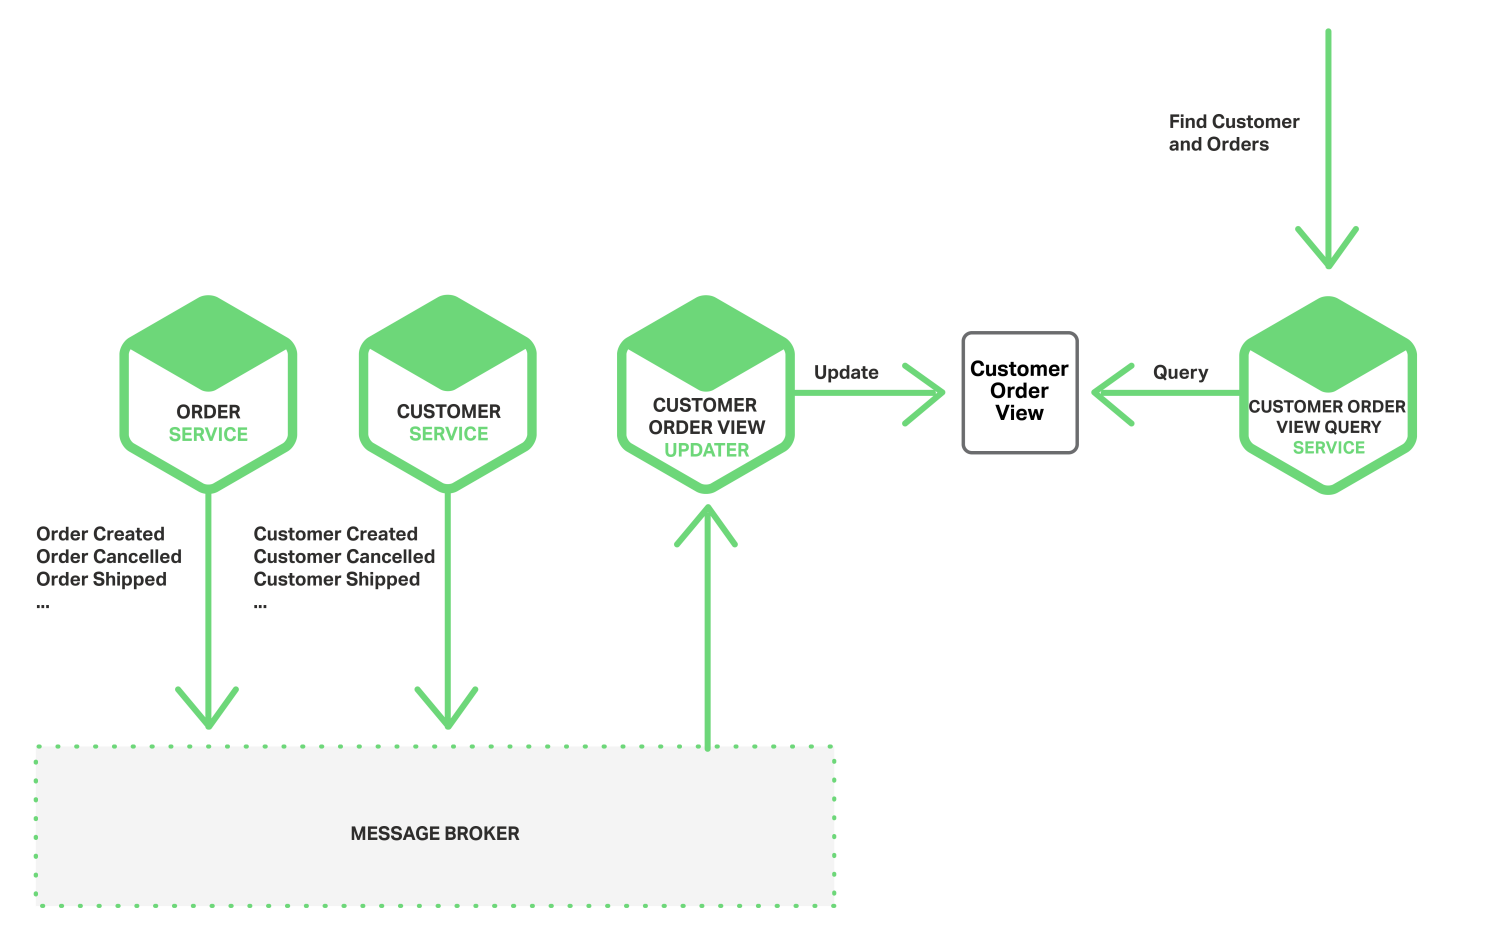
当客户订单视图更新服务收到客户或订单事件时,会更新客户订单视图数据存储。可以使用MongoDB等文档数据库实现客户订单视图,并为每个客户存储一个文档。客户订单视图查询服务通过查询客户订单视图数据存储,处理有关客户及其近期订单的请求。
事件驱动架构有多项优点,也存在一些缺点。它支持实现跨多个服务并提供最终一致性的事务。另一个优点是,应用可以借此维护物化视图。其缺点之一是,与使用ACID事务相比,编程模型更为复杂。通常必须实现补偿事务,以便从应用级故障中恢复。例如,如果信用检查失败,则必须取消订单。此外,应用还必须处理数据不一致问题。这是因为进行中事务所做的更改是可见的。如果应用从尚未更新的物化视图中读取数据,也可能会看到不一致的数据。另一个缺点是,订阅者必须检测并忽略重复事件。
实现原子性
在事件驱动架构中,还需要解决以原子方式更新数据库并发布事件的问题。例如,订单服务必须在 ORDER 表中插入一行,并发布“订单已创建”事件。这两项操作必须以原子方式完成。如果服务在更新数据库后、发布事件前崩溃,系统就会出现不一致。确保原子性的标准方法是使用涉及数据库和消息代理的分布式事务。然而,出于上述原因(例如 CAP 定理),这恰恰是我们不希望采用的做法。
使用本地事务发布事件
实现原子性的一种方法是让应用程序使用仅涉及本地事务的多步骤流程来发布事件。关键是在存储业务实体状态的数据库中创建一个EVENT表,将其用作消息队列。应用程序启动一个(本地)数据库事务,更新业务实体的状态,将事件插入EVENT表,然后提交事务。另一个应用程序线程或进程查询EVENT表,将事件发布到消息代理,然后使用本地事务将事件标记为已发布。下图展示了这一设计。
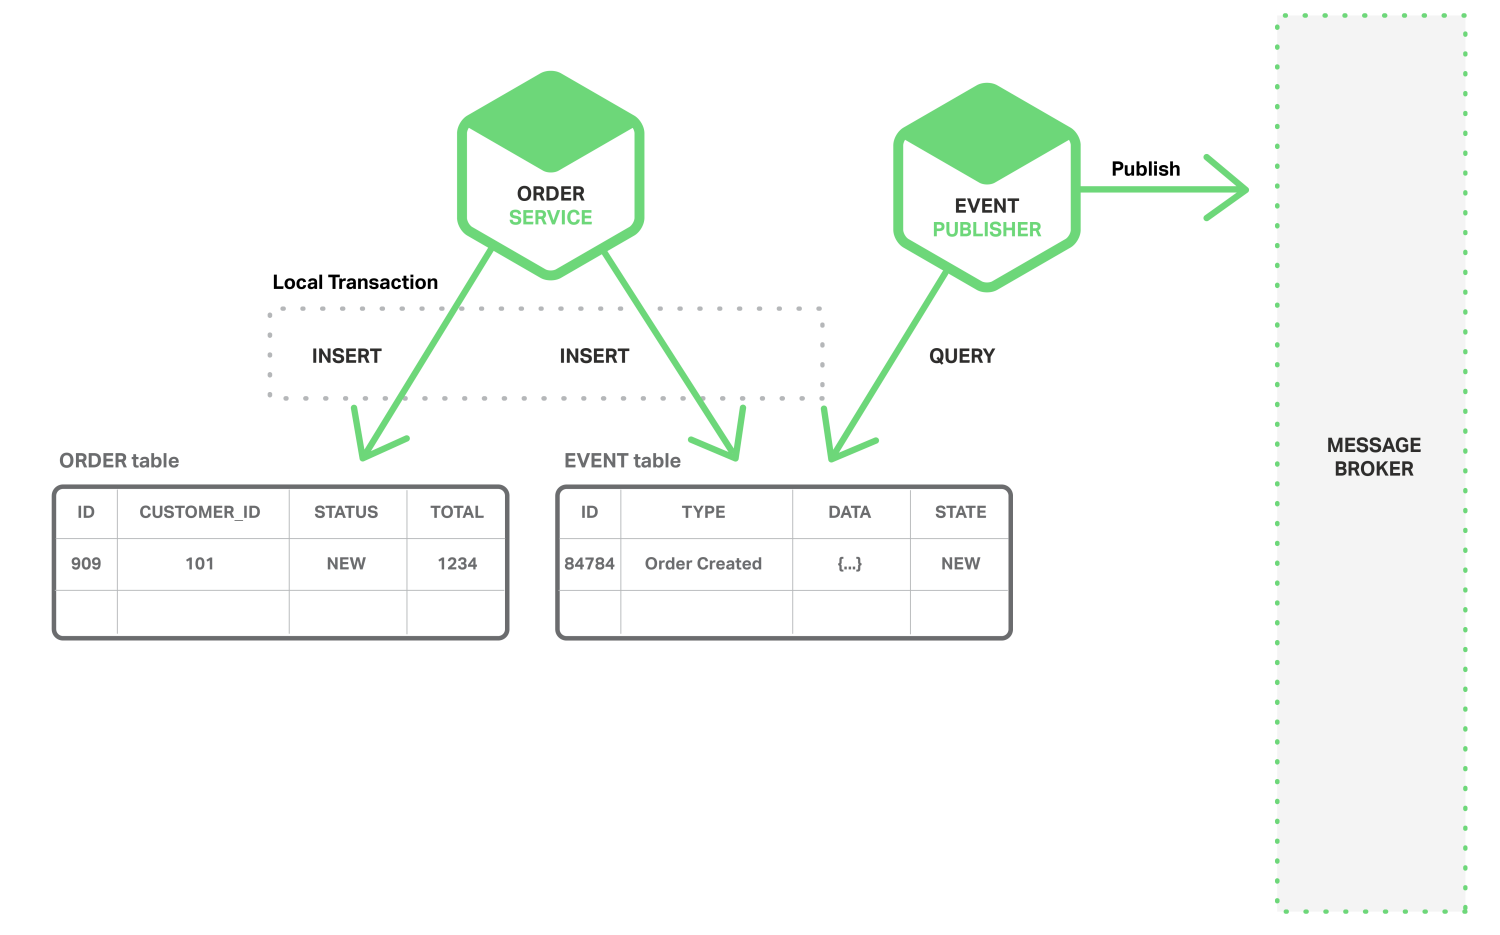
订单服务在ORDER表中插入一行,并在EVENT表中插入一个“订单已创建”事件。事件发布器线程或进程查询EVENT表中的未发布事件,发布这些事件,然后更新EVENT表,将这些事件标记为已发布。
这种方法有多项优点和缺点。其优点之一是,无需依赖2PC,即可保证每次更新都会发布一个事件。此外,应用程序会发布业务级事件,因此无需推断这些事件。这种方法的一个缺点是可能容易出错,因为开发人员必须记得发布事件。其局限性在于,某些NoSQL数据库的事务和查询能力有限,因此使用这些数据库时很难实现这种方法。
这种方法让应用程序使用本地事务更新状态并发布事件,从而无需使用2PC。下面来看另一种方法:应用程序只需更新状态,即可实现原子性。
挖掘数据库事务日志
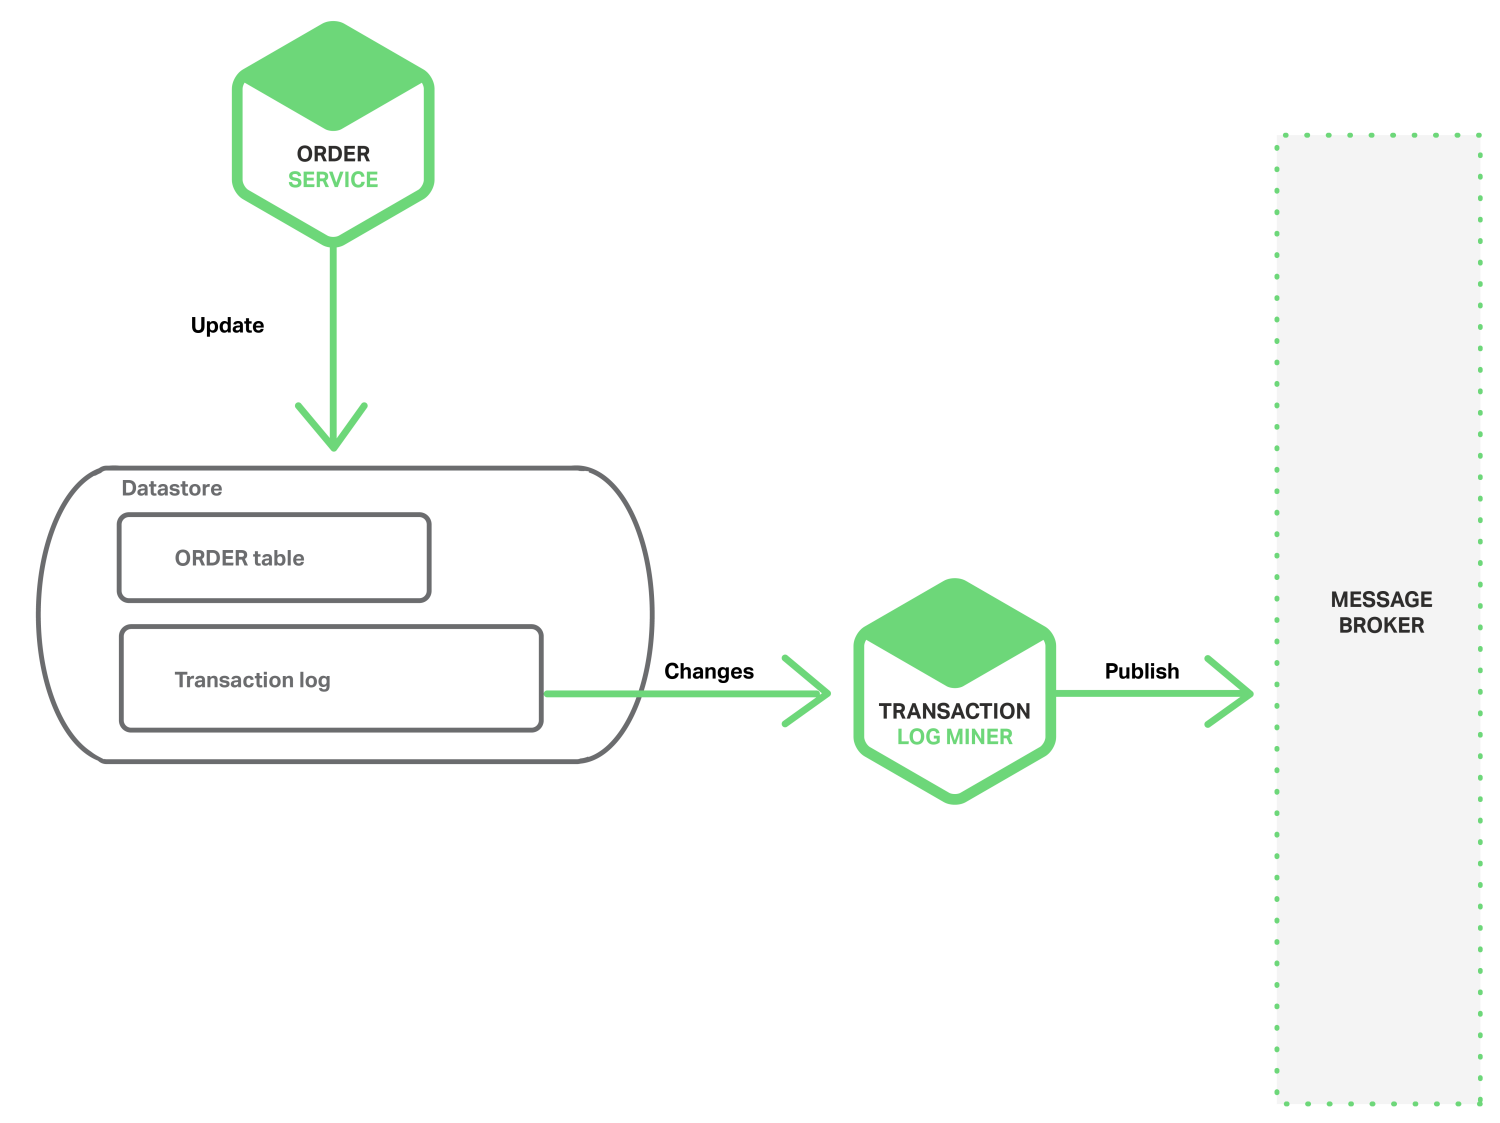
在不使用2PC的情况下实现原子性的另一种方法是,由一个挖掘数据库事务日志或提交日志的线程或进程发布事件。应用程序更新数据库,由此产生的更改会记录在数据库的事务日志中。事务日志挖掘器线程或进程读取事务日志,并将事件发布到消息代理。下图展示了这一设计。
这种方法的一个示例是开源项目LinkedIn Databus。Databus会挖掘Oracle事务日志,并发布与变更对应的事件。LinkedIn使用Databus,使各种派生数据存储与记录系统保持一致。
另一个示例是AWS DynamoDB中的流机制。AWS DynamoDB是一种托管式NoSQL数据库。DynamoDB流包含过去24小时内对DynamoDB表中项目所做更改(创建、更新和删除操作)的时间顺序序列。应用程序可以从流中读取这些更改,例如将其发布为事件。
事务日志挖掘有多种优点和缺点。其优点之一是,无需使用两阶段提交(2PC),即可确保每次更新都会发布一个事件。事务日志挖掘还可以将事件发布与应用程序的业务逻辑分离,从而简化应用程序。一个主要缺点是,每种数据库都有专有的事务日志格式,而且不同数据库版本之间的格式甚至可能发生变化。此外,要根据事务日志中记录的低级更新逆向推导出高级业务事件,可能会很困难。
事务日志挖掘让应用程序只需执行一项操作,即更新数据库,从而无需使用2PC。下面来看另一种方法:不再执行更新,而是完全依赖事件。
使用事件溯源
事件溯源采用一种截然不同的、以事件为中心的方式来持久化业务实体,无需2PC即可实现原子性。应用程序并不存储实体的当前状态,而是存储一系列改变状态的事件。应用程序通过重放这些事件来重建实体的当前状态。每当业务实体的状态发生变化时,都会在事件列表中追加一个新事件。由于保存事件是单一操作,因此本身具有原子性。
要了解事件溯源的工作原理,可以以Order实体为例。在传统方法中,每个订单映射到ORDER表中的一行,以及ORDER_LINE_ITEM等表中的相应行。但使用事件溯源时,Order Service会以状态变更事件的形式存储Order:Created、Approved、Shipped、Cancelled。每个事件都包含足以重建Order状态的数据。
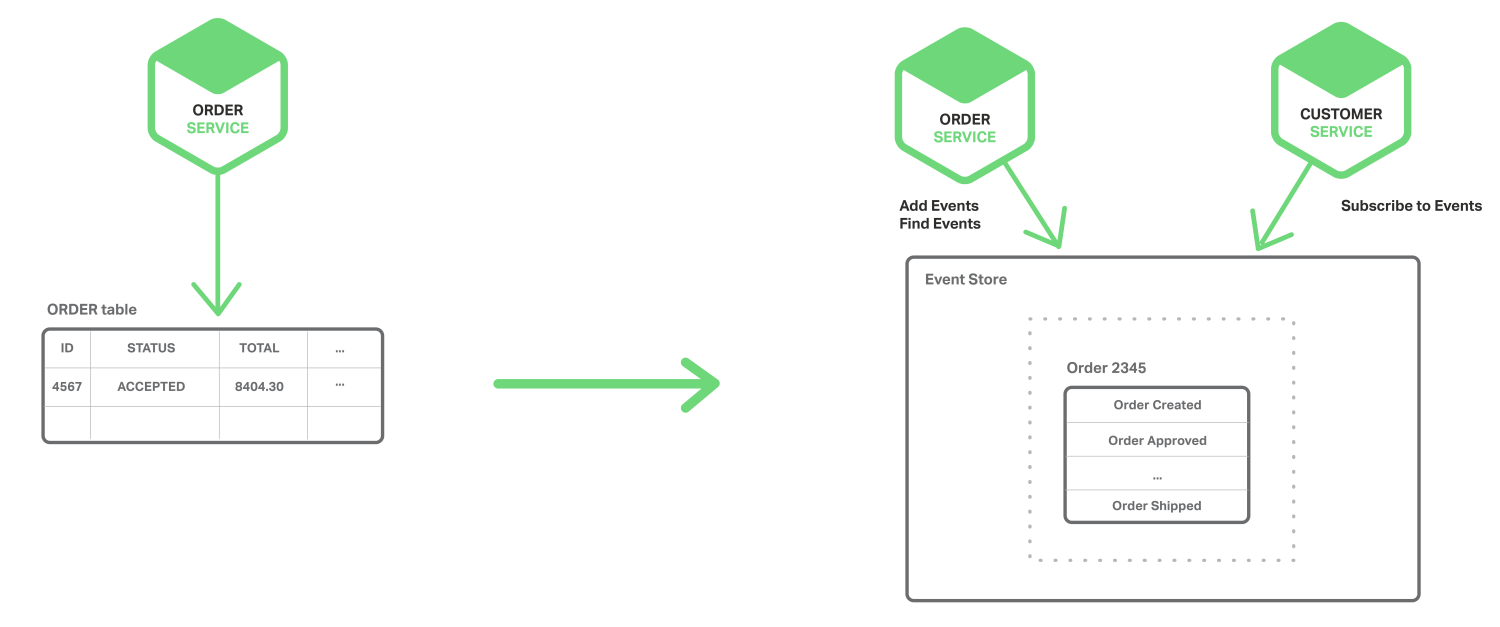
事件持久存储在事件存储中,事件存储是一个事件数据库。该存储提供API,用于添加和检索实体的事件。事件存储还发挥着与前述架构中的消息代理相同的作用。它提供API,使服务能够订阅事件。事件存储会将所有事件传递给所有感兴趣的订阅者。事件存储是事件驱动型微服务架构的支柱。
事件溯源具有多项优势。它解决了实现事件驱动架构时的一个关键问题,使系统能够在状态发生变化时可靠地发布事件,从而解决微服务架构中的数据一致性问题。此外,由于它持久化的是事件而非领域对象,因此基本避免了对象关系阻抗不匹配问题。事件溯源还可为业务实体的变更提供100%可靠的审计日志,并支持通过时态查询确定实体在任意时间点的状态。事件溯源的另一项主要优势是,业务逻辑由通过事件交互的松耦合业务实体组成。这使得从单体应用迁移到微服务架构变得容易得多。
事件溯源也存在一些缺点。它是一种不同且不太为人熟悉的编程方式,因此需要一定的学习过程。事件存储仅直接支持按主键查找业务实体。必须使用“命令查询职责分离”(CQRS)来实现查询。因此,应用程序必须处理最终一致的数据。
总结
在微服务架构中,每个微服务都有自己的专用数据存储。不同的微服务可能使用不同的SQL和NoSQL数据库。虽然这种数据库架构优势显著,但也带来了一些分布式数据管理方面的挑战。第一个挑战是如何实现业务事务,以保持多个服务之间的一致性。第二个挑战是如何实现从多个服务检索数据的查询。
对于许多应用,解决方案是采用事件驱动架构。实现事件驱动架构时面临的一项挑战是,如何以原子方式更新状态并发布事件。可通过多种方式实现这一点,包括将数据库用作消息队列、挖掘事务日志以及采用事件溯源。
在后续博文中,我们将继续深入探讨微服务的其他方面。
编者:本系列共7篇文章,现已全部发布:
- 微服务简介
- 构建微服务:使用API网关
- 构建微服务:微服务架构中的进程间通信
- 微服务架构中的服务发现
- 微服务的事件驱动型数据管理(本文)
- 选择微服务部署策略
- 将单体应用重构为微服务
还可以下载包含全套文章及使用NGINX Plus实施微服务相关信息的电子书:《微服务:从设计到部署》。另请参阅我们的微服务参考架构系列和微服务解决方案页面。
客座博主Chris Richardson是早期网站CloudFoundry.com的创始人。该网站是面向Amazon EC2的早期Java平台即服务(PaaS)。他目前为各组织提供咨询服务,帮助改进应用开发和部署方式。他还定期在http://microservices.io上发布有关微服务的博文。
相关博客文章

NGINX Plus R26 正式发布
NGINX Plus R26通过缓存JSON Web密钥集加快JWT验证,并强化TLS握手,从而提升安全性。NGINX JavaScript的新功能包括增强对异步函数的支持,以及实现WebCrypto API。
使用NGINX App Protect DoS保护gRPC应用,抵御严重的DoS攻击
gRPC具备开发人员设计和部署现代应用所需的速度与灵活性,但其开放性也使其极易受到第7层DoS攻击。NGINX App Protect DoS可保护gRPC应用免受此类破坏性攻击。
Ingress Controller 选型指南(第 2 部分):风险与面向未来的规划
了解选择错误的Ingress控制器可能带来的风险,以及如何从关键方面着手,让您的选择更好地适应未来需求。
NGINX Plus R19 正式发布
NGINX Plus R19扩展了监控功能,不仅提供更多指标,还新增了指标分析方式;增加试运行模式,用于测试限速效果;增强键值存储,以支持IP地址范围;并使限速更加动态。
NGINX现已正式加入F5
NGINX现已正式成为F5的一部分。Gus Robertson现任F5 NGINX业务部门负责人。他阐述了两家公司在人才、文化和愿景方面融合的价值,以及双方将如何携手增强NGINX的开源产品和商业产品。
